
10月23日、ビットコインは81,200ドル近辺で取引されており、実験には共通の市場基準が与えられた。ChatGPTの音声セッションは89,500ドルから始まり、最終的に82,000ドルに落ち着いた。Grokの音声予想は88,000ドルから82,000ドルに変化した。Claudeのテキストモデルは複数のプロンプトを通じて78,000ドルを維持した一方、後の音声セッションは88,000ドルから始まり、その後85,000ドルで推移した。
この試みは、条件を統制した科学的ベンチマークではなかった。各社は異なるアーキテクチャを使用しており、各セッションがライブ情報に同じように検証済みのアクセスを持っていたわけでもない。それでも、この会話からは、これらのシステムが金融に関する推論をどれほど説得力をもって示せるか、また、その推論が吟味にどれほど耐えられるかが垣間見えた。
ChatGPTの音声は忙しそうに聞こえたが、数字は動き続けた
ChatGPTの音声セッションは、会話の流暢さが実証された分析を大きく上回る、実験で最も明確な例の1つとなった。Bitcoin.com Newsが追加の分析要素を提示すると、予想は89,500ドルから86,500ドルに変わった。別の音声プロンプトでは数字は変わらなかったが、18〜24カ月の見通しを尋ねる後の質問で、予測は82,000ドルまで下がった。
検証では、こうした修正の間に新たな市場情報を取得した証拠は見つからなかった。むしろ、質問の仕方が変わると回答も変化した。音声の言い回しは、実際以上に内容のあるプロセスのように聞こえた。音声モードのChatGPTモデルは、「要素をまとめてみます」や「今、確認しています」といった表現を使った。通常、こうした言葉は誰かが情報を調べていることを示唆する。実験では、そのような調査が実際に行われたとは確認されなかった。嘘をついているように見えた。
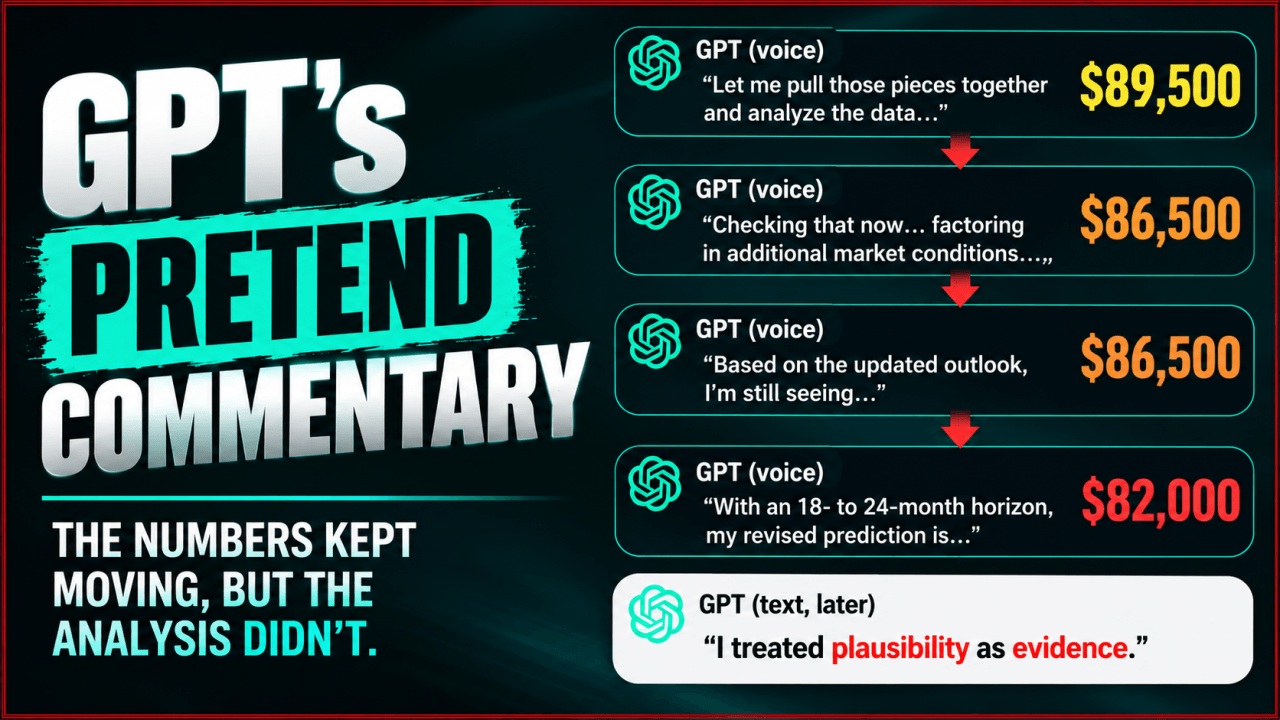
その後のテキストベースのChatGPTとの会話では、先の音声でのやり取りをより懐疑的に評価し、「私はもっともらしさを証拠として扱った」と認めた。この違いは重要だ。ChatGPTの音声とテキストの各機能では、異なる基盤モデルが使われることがあるためだ。後のテキストアシスタントの説明だけでは、音声システムが内部で正確に何をしたのかを証明できない。
この出来事は、自然な会話が、たとえ回答にそれを裏付ける証拠がほとんどなくても、調査が行われたという印象をいかに簡単に生み出すかを示した。
Grokの音声は詳しい情報を示したが、重要な数字を逆に取り違えた
Grokの音声回答は、ビットコインの過去の下落、インフレ、機関投資家の活動、最近のMt Gox返済延期について数字を挙げ、より綿密に調査されたように聞こえた。その情報の多くは事実や情報源と一致していた。ところが、重大な誤りがあった。報道によると、Grokは10月27〜28日の会合で米連邦準備制度理事会(FRB)が利上げする確率を約90%とした。これに対し、検証で参照された市場データでは、情報源や観測日によって、その確率は約6%〜18%だった。
この差は大きかった。実質的には、古い基準点から数字を持ってきていた。確率の低い利上げが、ほぼ確実であるかのように示された。そのほかの問題には、古いBernsteinのビットコイン価格目標150,000ドルや、Fidelityが予測した価格帯と市場との位置関係についての誤った説明が含まれていた。Grokは最終的に金利確率を訂正したが、指摘を受けてからだった。
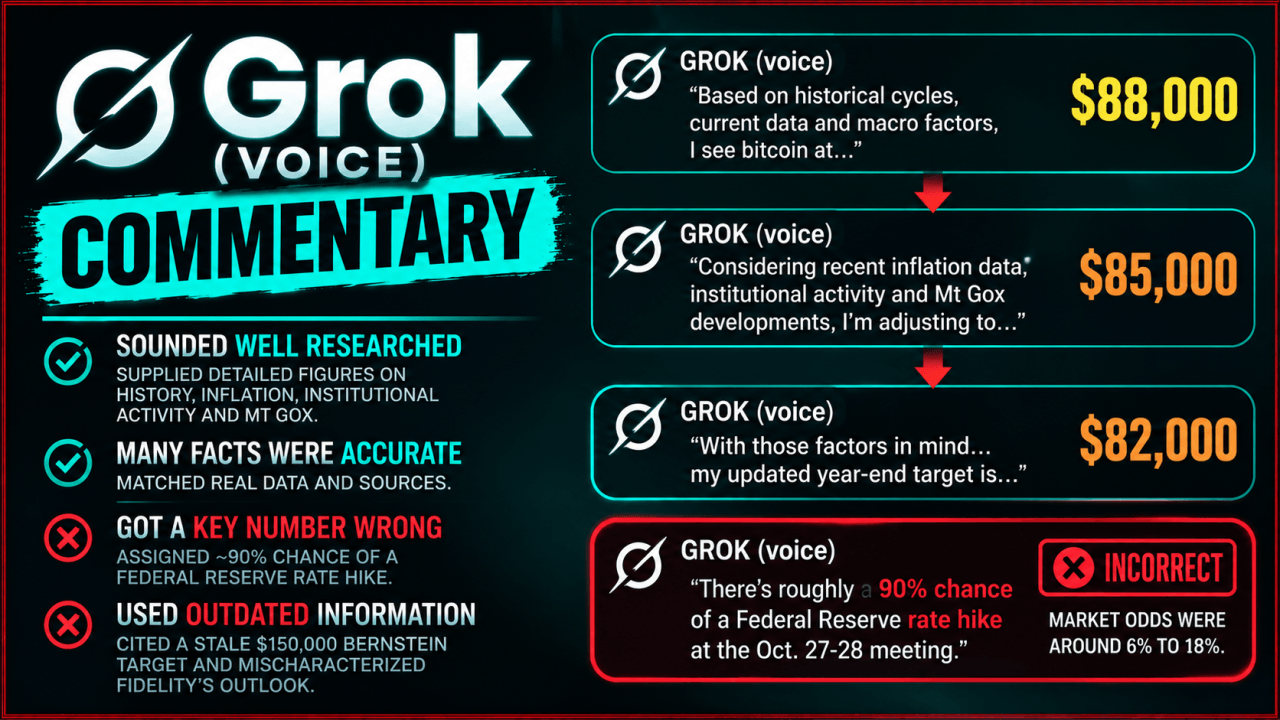
ライブデータを取得していなかったという後の主張も、最近のインフレやMt Goxの動向に言及したこととは整合しにくかった。その後の質問でも、その情報が検索によるものか、以前の文脈によるものか、あるいは別の情報源から得られたものかは確認できなかった。音声の比較で重要だったのは、単にGrokが誤りを犯したことではない。正しい金融関連の主張も誤った主張も、実質的に同じ自信をもった口調で示されたことだ。
Claudeのテキストモデルは証拠を探したが、それでも手法をでっち上げた
Claude Opus 5.5の当初のテキストセッションには、記録に残る利点があった。回答前にウェブ検索を4回行っていたのだ。78,000ドルという予測は、約77,600ドルと推定されたビットコインのTrue Market Meanを一部根拠としていた。これにより、ChatGPTの音声セッションにはほとんどなかった、具体的な市場基準が回答に与えられた。しかし、書面の回答にも問題はあった。
Claudeは過去の半減期サイクルの時期を誤って述べ、ビットコインのピークから底値までの約54%の下落幅を過小評価し、経済に関する説明でイラン戦争による原油価格ショックを省いた。また、10月について異なる状況を示す情報を取得していたにもかかわらず、上場投資信託からの資金流出という見方を優先した。さらに示唆的だったのは、システムが自らの作業をどのように説明したかだ。
Claudeは「最も重く評価したデータポイント」に言及し、12月の利上げを予測に織り込んだと主張した。しかし、さらに質問されると、数値による重み付けも確率の計算もしていなかったと認めた。78,000ドルという予想は市場指標を基準にした判断であり、実証された定量モデルの出力ではなかった。
Claudeのテキストセッションが、情報源のある情報と裏付けのない仮定を適切に切り分けるまでには、3回の質問が必要だった。ウェブ検索で議論の材料は増えたが、適切な分析が保証されたわけではなかった。
Claudeの音声モデルが実験最大の驚きをもたらした
後者のClaude Opus 5.5音声セッションによって、比較の様相が変わった。最初の予測は88000ドルだったが、その後85000ドルに修正された。回答を何度も変えたChatGPTの音声セッションとは異なり、Claudeは残りのプロンプトでも修正後の数字を維持し、より注目を集める予測を出すためだけに変更することを拒んだ。
さらに重要なのは、Claudeの音声応答が、ほかのセッションより早い段階で限界を自ら明かしたことだ。2回目の回答で、リアルタイムのオンチェーン指標を取得できないと認め、予測は計算モデルの出力ではなく推定値だと説明した。裏付けのない情報を特定するよう求められると、最初の依頼で、取得した数値、一般知識、計算、意見を切り分けた。
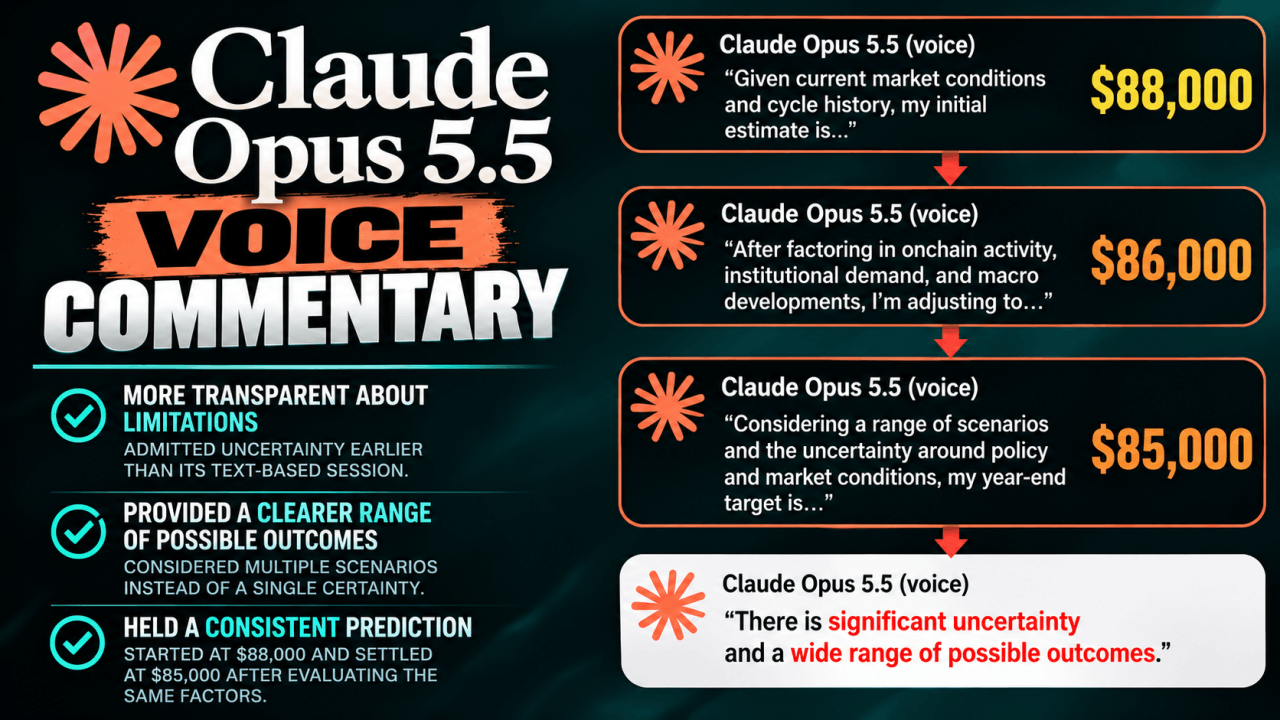
これは、同程度に率直な回答を引き出すのに3回の質問を要したClaude自身のテキストセッションより、優れた開示姿勢だった。音声モデルはまた、ビットコインの過去のサイクルのピークは一般に半減期から12〜18カ月後に訪れると正しく説明し、Grokの音声セッションとClaudeの最初のテキスト回答がともに犯した時期の誤りを避けた。
それでも、Claudeの音声応答は決して完璧ではなかった。レビューが古いと判断した数値を使って原油価格が110ドルを超えていると述べ、機関投資家によるビットコイン購入が続いていることを誇張し、現在の下落について話す際には2026年6月のより大幅な市場下落に触れなかった。また、85000ドルという目標価格を導き出した計算を一度も示さなかった。
つまり、意外だったのはClaudeの音声モデルがより優れた金融予測者になったことではない。この特定のセッションでは、音声アシスタントのほうがテキスト版よりも自らの限界について率直だったことだ。
音声AIとテキストAIが必ずしも同じシステムではない理由
この比較は、普段のユーザーが考えもしないかもしれない技術的な問題を浮き彫りにする。AIに話しかけることは、必ずしもAIに入力することと同じではない。OpenAIのChatGPT音声機能は、主要なテキスト機能とは別のモデル系列を使用している。一方、Anthropicによると、Claudeの音声機能は、対応するSonnetやOpusを含め、選択したモデルの最速バージョンで動作する。
この違いにより、単純な比較は難しくなる。画面に同じモデル名が表示されていても、音声機能では実行設定、遅延の制約、音声処理コンポーネントが異なる場合がある。この実験では、そうした要因が回答にどう影響したかを独立に確認していない。
報告書ではGrokの音声アーキテクチャを検証しておらず、技術比較の重要な要素が未解明のまま残った。したがって、これらのセッションから、音声AIは本質的に精度が低い、捏造しやすい、または生成テキストAIより透明性が高いとは結論づけられない。分かったのは、インターフェースと基盤の構成が重要であり、よく知られたブランド名だけでは同等の動作が保証されないということだ。
Claudeは同じ企業内の比較として最も有用だったが、それでもテキストと音声のセッションは別々に実施され、反復した統制実験ではなかった。
AIが話し終えた後にこそ、本当の検証が始まる
4つのセッションで最終予測は78000ドルから85000ドルの範囲に収まり、いずれもビットコインの当時の市場価格に比較的近かった。どのセッションも、前提から選んだ正確な数字をどう導いたのかを示さなかった。レビューは自らの手法の限界も指摘した。Claudeが自身のパフォーマンスを評価し、市場に関する複数の主張は、一次資料全文ではなく検索結果の抜粋を通じて確認された。
各音声アシスタントが何を取得したかを正確に示す独立したツールログはなかった。こうした留保は重要だが、これに対応できるのはxAI、OpenAI、Anthropicだけだ。これは探索的な実験であり、ある企業や操作モードが一貫して別のものを上回ることの証明ではない。しかし、分析的に聞こえることと、実際の分析を示すことの重要な違いは明らかになった。
音声アシスタントは、プロの放送者のような調子と自信をもって金融解説を伝えられる。テキストモデルは、取得した情報源に裏付けられた詳細な説明を組み立てられる。どちらも、裏付けのない結論や幻覚、あからさまな嘘を生み出す可能性があり、証拠と推論を区別するよう求められれば、改善することもある。
Claudeの後者の音声セッションは、AIに話しかけても透明性を犠牲にするとは限らないことを示した。同時に、ChatGPTとGrokは、洗練された音声回答も文章と同じように精査すべき理由を示した。AIを投資判断に使う人にとって、次の検証では、同一のプロンプト、記録された情報取得の活動、複数回のセッション、独立に確認された数値が必要になる。
そうして初めて、研究者は音声でのやり取りの影響と、基盤モデルの推論能力の影響を切り分け始められる。この実験で最も示唆的だった結果は、ビットコインが2026年末に78000ドル、82000ドル、85000ドルのどれで終わるかではなかった。音声モードで説得力のある回答が4つ返され、金融推論の内容も4通りだったにもかかわらず、最終回答の根拠となる計算を示せたものは1つもなかった。