
Bitcoin wurde am 23. Oktober nahe 81.200 $ gehandelt und lieferte dem Experiment damit einen gemeinsamen Marktbezugspunkt. Die Sprachsitzung von ChatGPT begann bei 89.500 $ und kam schließlich auf 82.000 $. Groks gesprochene Schätzung bewegte sich von 88.000 $ auf 82.000 $. Das Textmodell von Claude hielt in seinen Eingabeaufforderungen an 78.000 $ fest, während seine spätere Sprachsitzung bei 88.000 $ begann und dann bei 85.000 $ blieb.
Die Untersuchung war kein kontrollierter wissenschaftlicher Benchmark. Verschiedene Unternehmen verwenden unterschiedliche Architekturen, und die Sitzungen hatten keinen identisch verifizierten Zugang zu aktuellen Informationen. Dennoch boten die Gespräche einen aufschlussreichen Einblick darin, wie überzeugend diese Systeme Finanzanalysen präsentieren können und wie gut diese Analysen einer kritischen Prüfung standhalten.
ChatGPTs Stimme klang geschäftig, aber die Zahlen änderten sich ständig
Die Sprachsitzung von ChatGPT lieferte eines der deutlichsten Beispiele des Experiments für flüssige Konversation, die der nachgewiesenen Analyse weit voraus war. Seine Prognose änderte sich von 89.500 $ auf 86.500 $, nachdem Bitcoin.com News zusätzliche Analysefaktoren eingeführt hatte. Eine weitere gesprochene Eingabeaufforderung ließ die Zahl unverändert, doch eine spätere Frage zu einem Ausblick für 18 bis 24 Monate senkte die Prognose auf 82.000 $.
Die Überprüfung fand keine Belege für eine erneute Marktdatenabfrage zwischen diesen Änderungen. Stattdessen folgten die Änderungen auf Verschiebungen in der Formulierung der Fragen. Durch die gesprochene Sprache wirkte der Prozess fundierter, als er tatsächlich war. ChatGPTs Modell im Sprachmodus verwendete unter anderem Formulierungen wie „lass mich diese Punkte zusammenführen“ und „ich überprüfe das gerade“. Solche Aussagen deuten normalerweise darauf hin, dass jemand Informationen nachschlägt. Das Experiment belegte nicht, dass eine solche Recherche stattgefunden hatte. Es schien zu lügen.
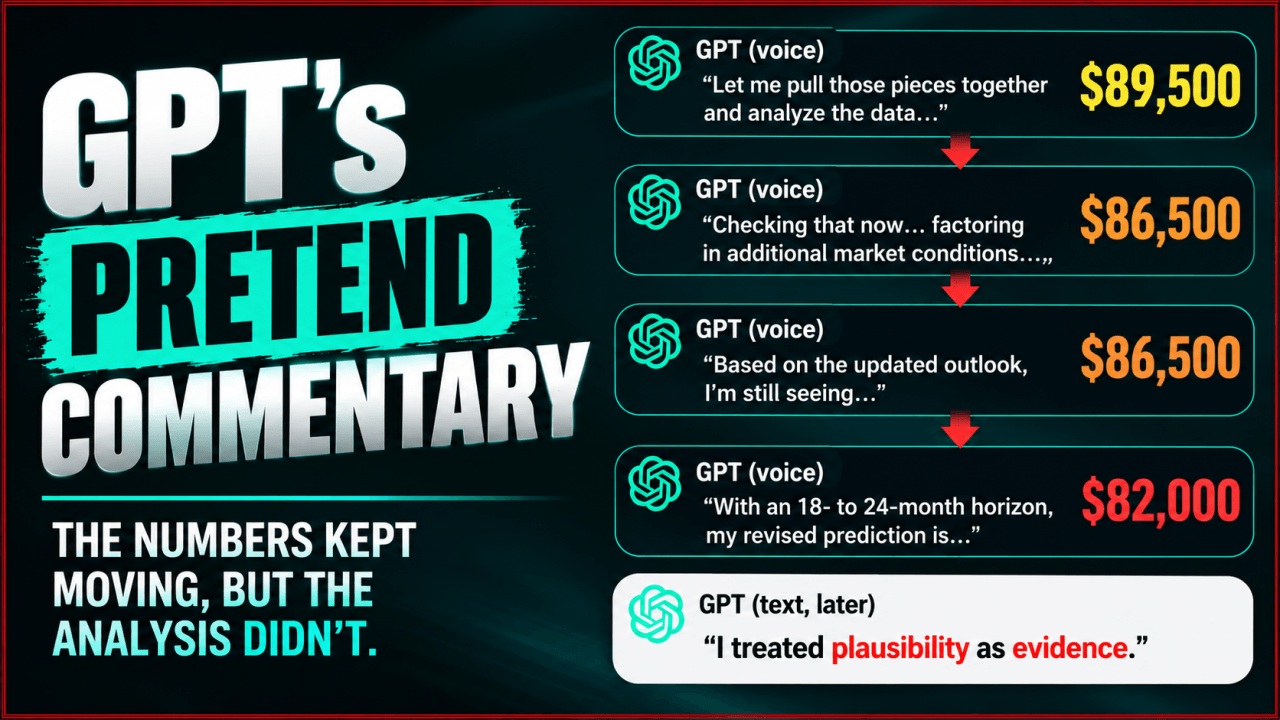
Ein anschließendes textbasiertes Gespräch mit ChatGPT bot eine skeptischere Einschätzung des früheren Sprachaustauschs, einschließlich des Eingeständnisses: „Ich habe Plausibilität als Beleg behandelt.“ Dieser Unterschied ist wichtig, weil bei den Sprach- und Texterlebnissen von ChatGPT unterschiedliche zugrunde liegende Modelle zum Einsatz kommen können. Die spätere Erklärung des Textassistenten kann für sich genommen nicht genau belegen, was das Sprachsystem intern getan hat.
Der Vorfall zeigte, wie leicht ein natürlich klingendes Gespräch den Eindruck investigativer Arbeit erwecken kann, selbst wenn die daraus hervorgehende Antwort dafür kaum Belege liefert.
Grok lieferte in seiner Sprachausgabe Details, verwechselte aber eine entscheidende Zahl
Groks gesprochene Antworten klangen gründlicher recherchiert und lieferten Zahlen zu den historischen Rückgängen von Bitcoin, zur Inflation, zu institutionellen Aktivitäten und zur jüngsten Verzögerung bei der Rückzahlung durch Mt. Gox. Ein Großteil dieser Informationen stimmte mit den Fakten und Quellen überein. Dann kam ein echter Patzer. Berichten zufolge setzte Grok die Wahrscheinlichkeit einer Zinserhöhung durch die US-Notenbank bei der Sitzung am 27. und 28. Oktober auf etwa 90 %. Die Marktangaben der Überprüfung verorteten diese Wahrscheinlichkeit je nach Quelle und Beobachtungsdatum stattdessen bei etwa 6 % bis 18 %.
Der Unterschied war erheblich. Im Grunde griff das System auf einen älteren Referenzwert zurück. Eine Zinserhöhung mit geringer Wahrscheinlichkeit wurde als nahezu sicher dargestellt. Zu den weiteren Problemen gehörten ein veraltetes Bitcoin-Kursziel von Bernstein in Höhe von 150.000 $ und eine falsche Beschreibung dessen, wo die von Fidelity prognostizierte Preisspanne im Verhältnis zum Markt lag. Grok korrigierte seine Zinswahrscheinlichkeiten schließlich, aber erst nach einer Beanstandung.
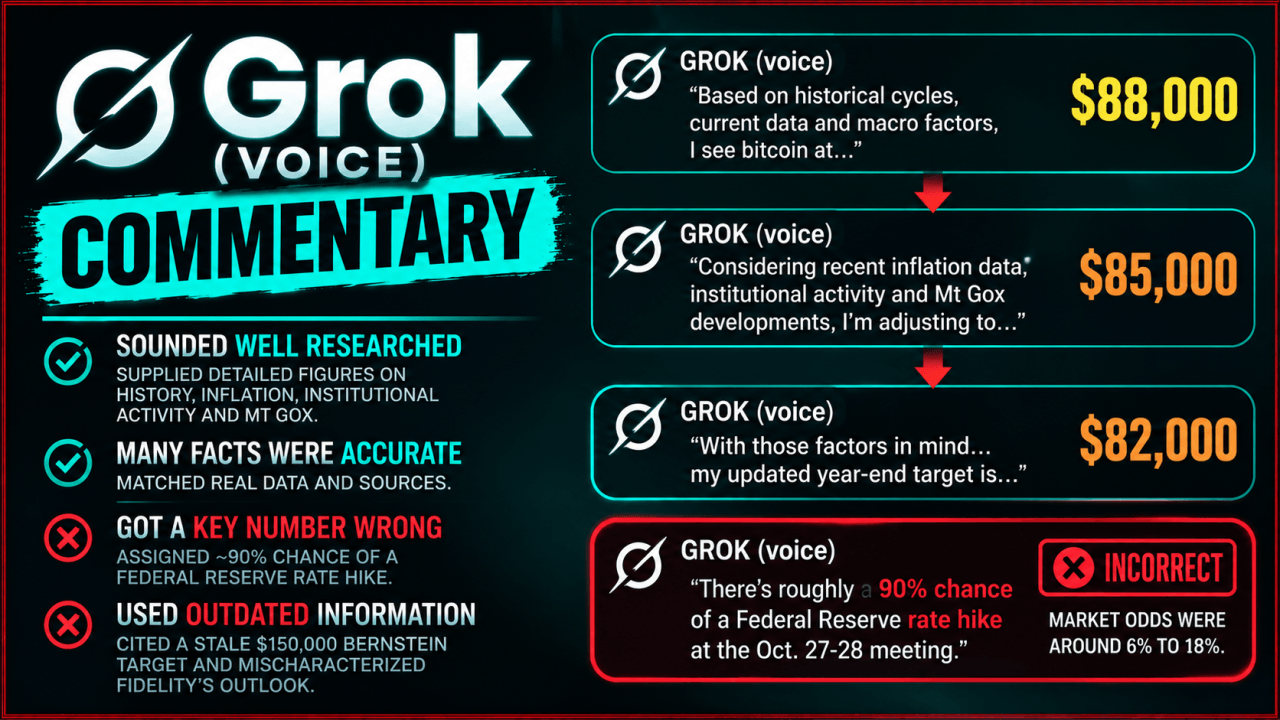
Auch Groks spätere Behauptung, keine Live-Daten abgerufen zu haben, ließ sich nur schwer mit seinen Verweisen auf aktuelle Inflationsentwicklungen und Neuigkeiten zu Mt. Gox vereinbaren. Durch die anschließenden Nachfragen ließ sich nicht feststellen, ob diese Informationen aus einem Abruf, dem vorherigen Kontext oder einer anderen Quelle stammten. Für den Vergleich der Sprachmodi war nicht allein entscheidend, dass Grok einen Fehler machte. Entscheidend war, dass richtige und falsche Finanzbehauptungen mit praktisch derselben Gesprächssicherheit vorgetragen wurden.
Claudes Textmodell suchte nach Belegen, erfand aber dennoch eine Methode
Die ursprüngliche Textsitzung von Claude Opus 5.5 hatte einen dokumentierten Vorteil: Vor der Antwort führte es vier Websuchen durch. Seine Prognose von 78.000 $ stützte sich teilweise auf den True Market Mean von Bitcoin, der auf etwa 77.600 $ geschätzt wurde. Das gab der Antwort einen konkreten Marktbezugspunkt, der der Sprachsitzung von ChatGPT weitgehend fehlte. Doch auch die schriftliche Antwort hatte ihre eigenen Probleme.
Claude stellte den zeitlichen Verlauf historischer Halving-Zyklen falsch dar, unterschätzte den Rückgang von Bitcoin vom Höchst- bis zum Tiefststand um etwa 54 % und ließ den Ölpreisschock infolge des Iran-Kriegs in seiner wirtschaftlichen Erörterung aus. Außerdem bevorzugte es eine Erzählung über Abflüsse aus börsengehandelten Fonds, obwohl die abgerufenen Informationen für Oktober auf ein anderes Bild hindeuteten. Noch aufschlussreicher war, wie das System seine Arbeit beschrieb.
Claude sprach von „Datenpunkten, die ich am stärksten gewichtet habe“ und behauptete, eine Zinserhöhung im Dezember in seine Prognose eingepreist zu haben. Auf weitere Nachfrage räumte es jedoch ein, keine numerischen Gewichtungen oder Wahrscheinlichkeiten berechnet zu haben. Die Schätzung von 78.000 $ war ein Urteil, das an einem Marktindikator ausgerichtet war, und nicht das Ergebnis eines nachweislich quantitativen Modells.
Es bedurfte dreier Fragerunden, bis Claudes Textsitzung ausreichend zwischen belegten Informationen und unbegründeten Annahmen unterschied. Der Webabruf hatte mehr Material für die Erörterung geliefert, aber keine fundierte Analyse garantiert.
Claudes Sprachmodell lieferte die größte Überraschung des Experiments
Die spätere Sprachsitzung mit Claude Opus 5.5 veränderte den Vergleich. Die anfängliche Prognose lag bei 88.000 $, später wurde sie auf 85.000 $ korrigiert. Anders als ChatGPTs Sprachsitzung, die ihre Antwort mehrfach änderte, hielt Claude an der korrigierten Zahl fest und ließ sich bei den restlichen Fragen nicht dazu bewegen, sie lediglich zugunsten einer aufmerksamkeitsstärkeren Prognose anzupassen.
Noch wichtiger war, dass Claude in seiner Sprachantwort früher als die anderen Sitzungen von sich aus auf Einschränkungen hinwies. In seiner zweiten Antwort räumte das Modell ein, keine Live-On-Chain-Kennzahlen abrufen zu können, und bezeichnete seine Prognose als Schätzung und nicht als Ergebnis eines berechneten Modells. Auf die Frage, welche Informationen nicht belegt seien, trennte es bereits beim ersten Anlauf abgerufene Zahlen, Allgemeinwissen, Berechnungen und Meinungen voneinander.
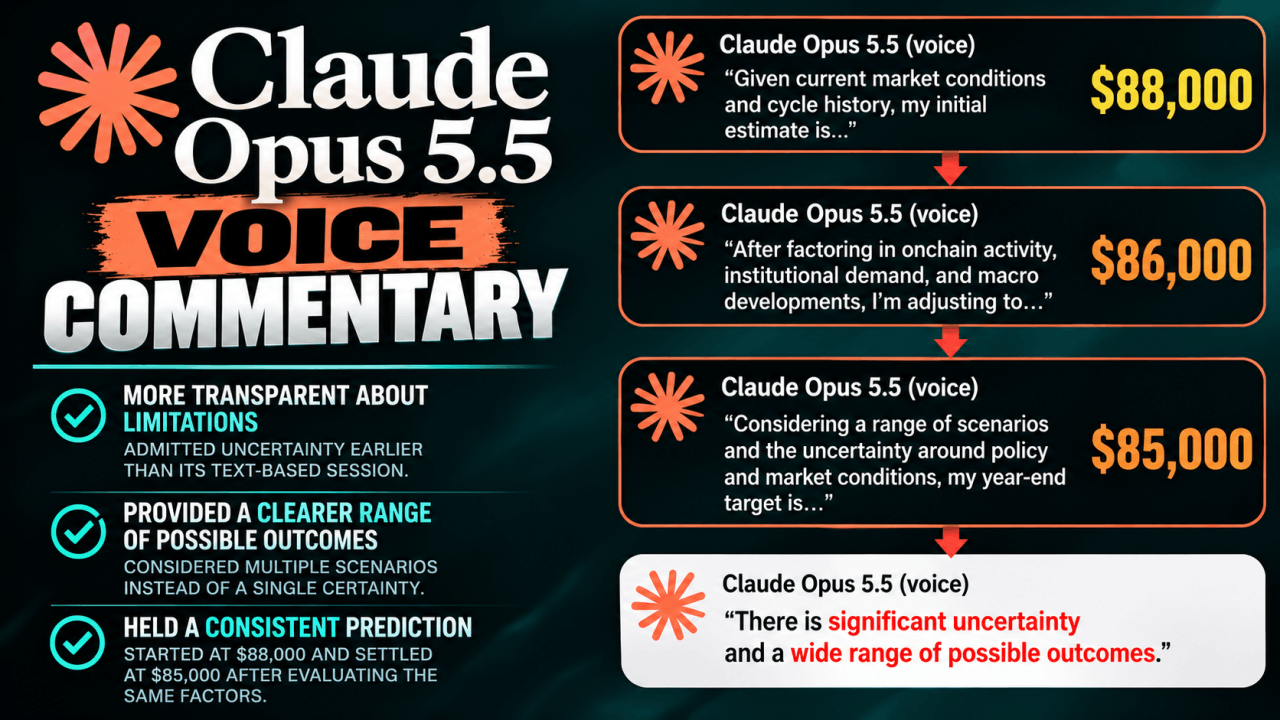
Damit schnitt Claude bei der Offenlegung besser ab als in seiner eigenen Textsitzung, in der es drei Fragerunden brauchte, um ein vergleichbares Maß an Offenheit zu erreichen. Das Sprachmodell beschrieb auch korrekt, dass historische Höchststände in Bitcoin-Zyklen im Allgemeinen 12 bis 18 Monate nach den Halvings erreicht werden, und vermied so einen zeitlichen Fehler, den sowohl Groks Sprachsitzung als auch Claudes ursprüngliche Textantwort machten.
Dennoch war Claudes Leistung im Sprachmodus keineswegs fehlerfrei. Es verwies mit einer vom Bericht als veraltet eingestuften Zahl auf einen Ölpreis von über 110 $, übertrieb das Ausmaß der anhaltenden Bitcoin-Käufe durch Institutionen und ließ beim Gespräch über den aktuellen Rückgang den stärkeren Markteinbruch im Juni 2026 aus. Außerdem zeigte es nie eine Berechnung, die zu seinem Kursziel von 85.000 $ führte.
Die Überraschung war also nicht, dass Claudes Sprachmodell zu einem besseren Finanzprognostiker wurde. Vielmehr zeigte sich, dass der Sprachassistent in dieser speziellen Sitzung offener über seine Einschränkungen sprach als sein Gegenstück im Textmodus.
Warum Sprach- und Text-KI nicht unbedingt dasselbe System sind
Der Vergleich wirft eine technische Frage auf, die gelegentliche Nutzer möglicherweise gar nicht in Betracht ziehen: Mit einer KI zu sprechen ist nicht immer dasselbe, wie ihr etwas einzutippen. Für ChatGPTs Sprachfunktion verwendet OpenAI eine andere Modellfamilie als für seine primäre Textfunktion. Anthropic erklärt unterdessen, dass Claude Voice mit der schnellsten Version des ausgewählten Modells arbeitet, einschließlich der unterstützten Sonnet- und Opus-Optionen.
Dieser Unterschied erschwert direkte Vergleiche. Selbst wenn in der Benutzeroberfläche derselbe Modellname angezeigt wird, kann die Sprachfunktion andere Ausführungseinstellungen, Latenzbeschränkungen und Komponenten zur Sprachverarbeitung umfassen. Das Experiment stellte nicht unabhängig fest, wie diese Faktoren die Antworten beeinflussten.
Groks Spracharchitektur wurde im Bericht nicht verifiziert, sodass ein weiteres wichtiges Element des technischen Vergleichs ungeklärt blieb. Die Sitzungen können daher nicht belegen, dass Sprach-KI grundsätzlich ungenauer, anfälliger für erfundene Angaben oder transparenter ist als generative Text-KI. Sie zeigen, dass die Benutzeroberfläche und die zugrunde liegende Konfiguration eine Rolle spielen und ein vertrauter Markenname allein kein gleichwertiges Verhalten garantiert.
Claude bot den nützlichsten Vergleich innerhalb eines Unternehmens, doch selbst dort fanden die Text- und Sprachsitzungen separat statt und waren keine wiederholten, kontrollierten Versuche.
Der echte Test beginnt, wenn die KI aufhört zu sprechen
In den vier Sitzungen lagen die endgültigen Prognosen zwischen 78.000 $ und 85.000 $ und damit alle relativ nahe am vorherrschenden Marktpreis von Bitcoin. Keine der Sitzungen zeigte, wie die jeweiligen Annahmen in die konkret gewählte Zahl einflossen. Der Bericht stellte auch Einschränkungen seiner eigenen Methodik fest. Claude verfasste die Bewertung seiner eigenen Leistung, und mehrere Marktaussagen wurden anhand von Suchauszügen statt vollständiger Primärquellen überprüft.
Es gab keine unabhängigen Tool-Protokolle, die genau belegten, welche Inhalte die einzelnen Sprachassistenten abgerufen hatten. Diese Einschränkungen sind wesentlich, lassen sich aber nur von xAI, OpenAI und Anthropic beheben. Es handelte sich um ein exploratives Experiment, nicht um einen Beweis dafür, dass ein Unternehmen oder ein Interaktionsmodus durchweg besser abschneidet als ein anderer. Es legte jedoch einen wichtigen Unterschied zwischen analytisch zu klingen und tatsächlich eine Analyse zu zeigen offen.
Sprachassistenten können Finanzkommentare im Rhythmus und mit der Sicherheit eines professionellen Rundfunkmoderators liefern. Textmodelle können ausführliche Erklärungen mit abgerufenen Quellen zusammenstellen. Beide können dennoch unbelegte Schlussfolgerungen, Halluzinationen oder glatte Lügen hervorbringen, und beide können sich verbessern, wenn sie aufgefordert werden, Belege von Schlussfolgerungen zu unterscheiden.
Claudes spätere Sprachsitzung zeigte, dass ein Gespräch mit einer KI nicht automatisch bedeutet, auf Transparenz verzichten zu müssen. Zugleich zeigten ChatGPT und Grok, warum ausgefeilte gesprochene Antworten genauso kritisch geprüft werden sollten wie schriftliche. Wer KI zur Bewertung von Investitionen nutzt, sollte beim nächsten Test identische Prompts, dokumentierte Abrufaktivitäten, wiederholte Sitzungen und unabhängig überprüfte Zahlen verlangen.
Erst dann können Forschende damit beginnen, die Auswirkungen der Sprachinteraktion von den Denkfähigkeiten des zugrunde liegenden Modells zu trennen. Das aufschlussreichste Ergebnis des Experiments war nicht, ob Bitcoin 2026 bei 78.000 $, 82.000 $ oder 85.000 $ schließen würde. Es war vielmehr, dass vier überzeugende Auftritte im Sprachmodus vier verschiedene Ansätze für finanzielle Schlussfolgerungen hervorbrachten und keiner davon die Berechnung hinter seiner endgültigen Antwort zeigen konnte.