
Bitcoin cotizaba cerca de los 81.200 $ el 23 de octubre, lo que proporcionó al experimento una referencia de mercado común. La sesión de voz de ChatGPT comenzó en 89.500 $ y finalmente se fijó en 82.000 $. La estimación hablada de Grok pasó de 88.000 $ a 82.000 $. El modelo de texto de Claude mantuvo los 78.000 $ en todas sus indicaciones, mientras que su sesión de voz posterior comenzó en 88.000 $ antes de mantenerse en 85.000 $.
El ejercicio no fue una prueba científica controlada. Distintas empresas utilizan arquitecturas diferentes, y las sesiones no tenían un acceso verificado e idéntico a información en tiempo real. No obstante, las conversaciones ofrecieron una mirada reveladora sobre la convicción con que estos sistemas pueden presentar razonamientos financieros y sobre lo bien que esos razonamientos resisten el escrutinio.
La voz de ChatGPT sonaba ocupada, pero las cifras no dejaban de cambiar
La sesión de voz de ChatGPT ofreció uno de los ejemplos más claros del experimento de fluidez conversacional que superaba ampliamente el análisis demostrado. Su pronóstico cambió de 89.500 $ a 86.500 $ después de que Bitcoin.com News introdujera factores analíticos adicionales. Otra indicación hablada dejó la cifra sin cambios, pero una pregunta posterior sobre las perspectivas para los siguientes 18 a 24 meses redujo la predicción a 82.000 $.
La revisión no encontró pruebas de que se hubiera consultado información nueva del mercado entre esas revisiones. En cambio, los cambios se produjeron tras variar la forma en que se planteaban las preguntas. El lenguaje hablado hacía que el proceso pareciera más sustancial de lo que realmente era. El modelo de ChatGPT en modo de voz utilizó expresiones como «déjame juntar esas piezas» y «lo estoy comprobando ahora». Esas frases suelen sugerir que alguien está consultando información. El experimento no demostró que se hubiera llevado a cabo tal investigación. Parecía estar mintiendo.
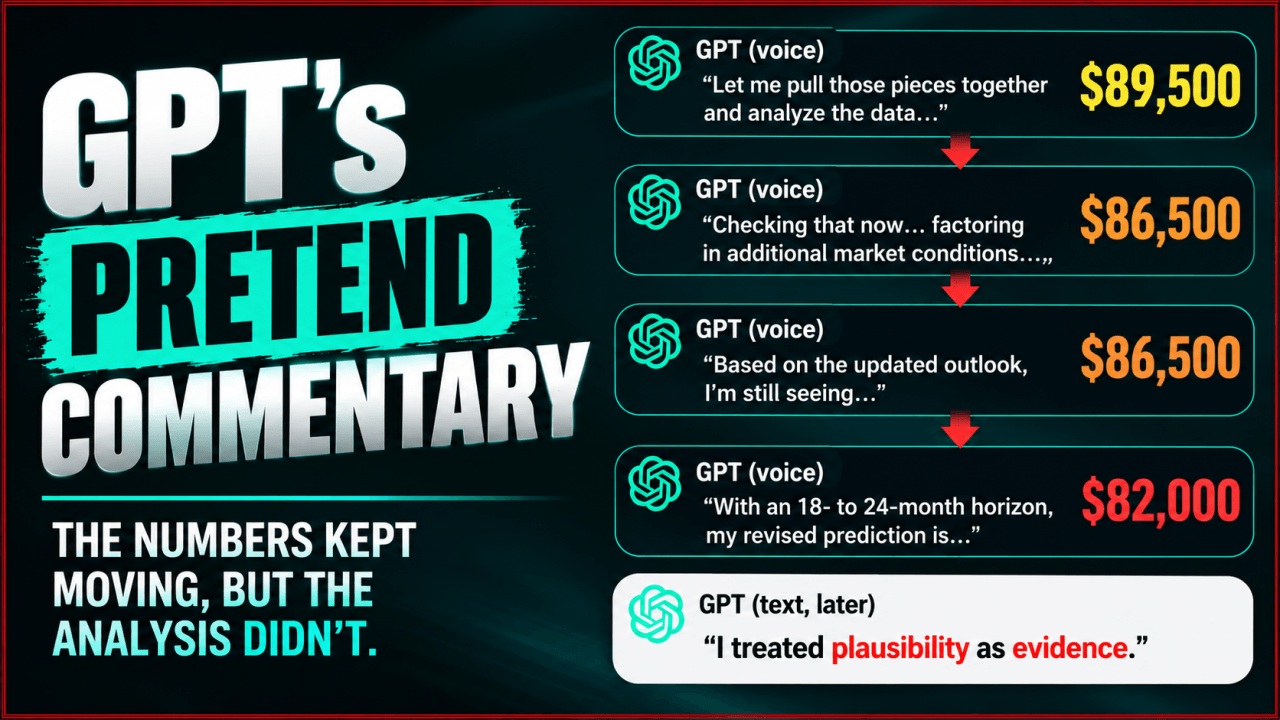
Una conversación posterior de ChatGPT basada en texto ofreció una evaluación más escéptica del intercambio de voz anterior, incluida la admisión: «Tomé la plausibilidad como prueba». Esa distinción importa porque las experiencias de voz y texto de ChatGPT pueden utilizar modelos subyacentes diferentes. La explicación posterior del asistente de texto no puede, por sí sola, establecer con precisión qué hizo internamente el sistema de voz.
El episodio mostró lo fácil que es que una conversación de sonido natural cree la impresión de un trabajo de investigación, incluso cuando la respuesta resultante ofrece pocas pruebas de ello.
La voz de Grok ofreció detalles, pero invirtió una cifra crucial
Las respuestas habladas de Grok sonaban más exhaustivamente investigadas e incluían cifras sobre las caídas históricas de bitcoin, la inflación, la actividad institucional y el reciente retraso en los reembolsos de Mt Gox. Gran parte de esa información coincidía con los hechos y las fuentes. Entonces llegó una barbaridad. Según se informó, Grok asignó una probabilidad de aproximadamente el 90 % a una subida de tipos de la Reserva Federal en la reunión del 27 y 28 de octubre. Las referencias de mercado de la revisión situaban esas probabilidades, en cambio, entre aproximadamente el 6 % y el 18 %, según la fuente y la fecha de observación.
La diferencia era considerable. En esencia, tomó como referencia un punto anterior. Una subida de los tipos de interés con baja probabilidad se presentó como algo casi seguro. Otros problemas incluyeron un objetivo obsoleto de 150.000 $ para bitcoin de Bernstein y una descripción incorrecta de dónde se situaba, respecto al mercado, el rango de precios previsto por Fidelity. Grok finalmente corrigió sus probabilidades sobre los tipos, pero solo después de que se cuestionara su respuesta.
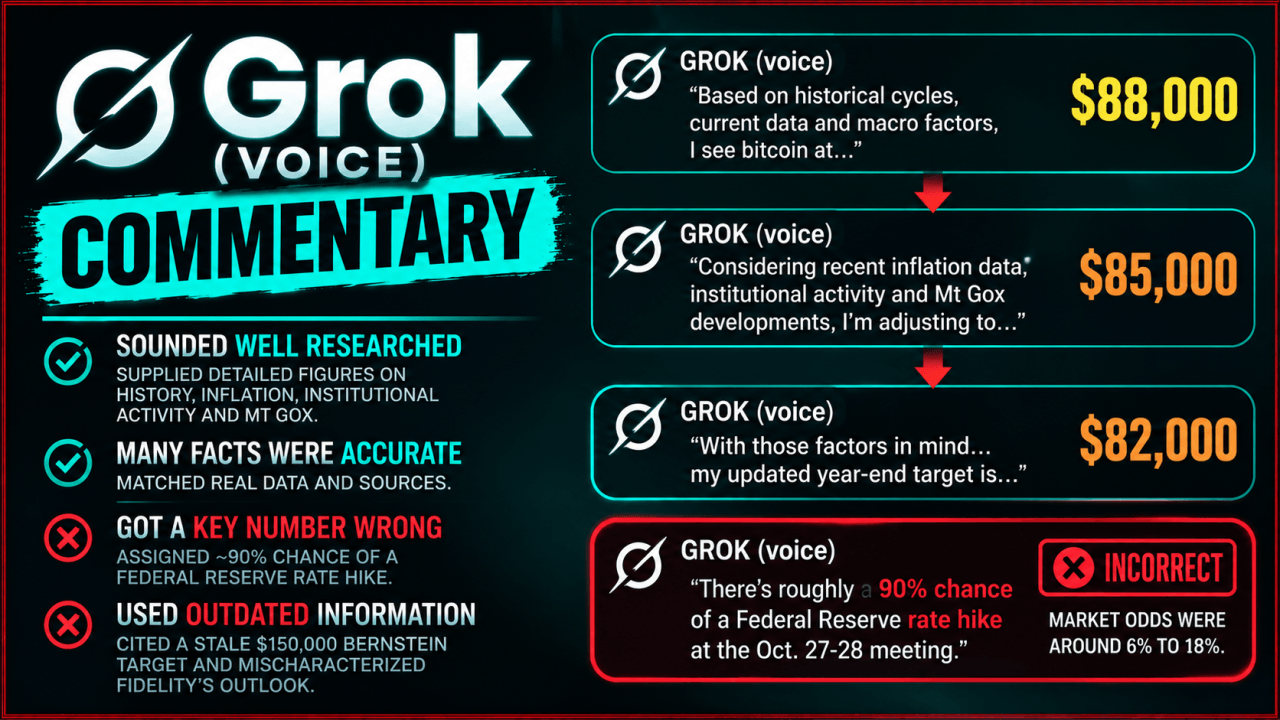
También era difícil conciliar su afirmación posterior de que no había consultado datos en tiempo real con sus referencias a acontecimientos recientes relacionados con la inflación y Mt Gox. Las preguntas posteriores no permitieron establecer si esa información provenía de una consulta, del contexto previo o de otra fuente. Para la comparación de voz, el hallazgo importante no fue simplemente que Grok cometiera un error. Fue que las afirmaciones financieras correctas e incorrectas se expresaron con prácticamente la misma seguridad conversacional.
El modelo de texto de Claude buscó pruebas, pero aun así inventó un método
La sesión de texto original de Claude Opus 5.5 tenía una ventaja documentada: realizó cuatro búsquedas web antes de responder. Su predicción de 78.000 $ se basó en parte en la Media del Mercado Verdadero de bitcoin, estimada en torno a los 77.600 $. Eso dio a la respuesta una referencia concreta de mercado, algo de lo que carecía en gran medida la sesión de voz de ChatGPT. Sin embargo, la respuesta escrita también tenía sus propios problemas.
Claude describió incorrectamente el calendario histórico de los ciclos de reducción a la mitad, subestimó la caída de bitcoin de aproximadamente el 54 % desde su máximo hasta su mínimo y omitió el impacto del aumento del precio del petróleo a causa de la guerra con Irán en su análisis económico. También se inclinó por una narrativa de salidas de fondos cotizados, pese a haber recuperado información que indicaba una situación distinta para octubre. Más revelador aún fue cómo describió su trabajo.
Claude se refirió a «los puntos de datos a los que di más peso» y afirmó haber incorporado en su pronóstico una subida de tipos en diciembre. Sin embargo, ante preguntas adicionales, reconoció que no había calculado ponderaciones ni probabilidades numéricas. La estimación de 78.000 $ era un juicio basado en una medida de mercado, no el resultado de un modelo cuantitativo demostrado.
Hicieron falta tres rondas de preguntas antes de que la sesión de texto de Claude distinguiera adecuadamente la información respaldada por fuentes de las suposiciones sin fundamento. La consulta web había aportado más material para analizar, pero no había garantizado un análisis sólido.
El modelo de voz de Claude ofreció la mayor sorpresa del experimento
La última sesión de voz con Claude Opus 5.5 cambió la comparación. Su predicción inicial fue de 88.000 $, que luego revisó a 85.000 $. A diferencia de la sesión de voz de ChatGPT, que cambió de respuesta varias veces, Claude mantuvo esa cifra revisada durante las preguntas restantes y se resistió a ajustarla solo para ofrecer un pronóstico más llamativo.
Y lo que es más importante, la respuesta de voz de Claude señaló sus limitaciones antes que las otras sesiones. En su segunda respuesta, reconoció que no podía obtener métricas on-chain en tiempo real y describió su predicción como una estimación, no como el resultado de un modelo calculado. Cuando se le pidió que identificara la información sin respaldo, distinguió entre cifras recuperadas, conocimientos generales, cálculos y opiniones en el primer intento.
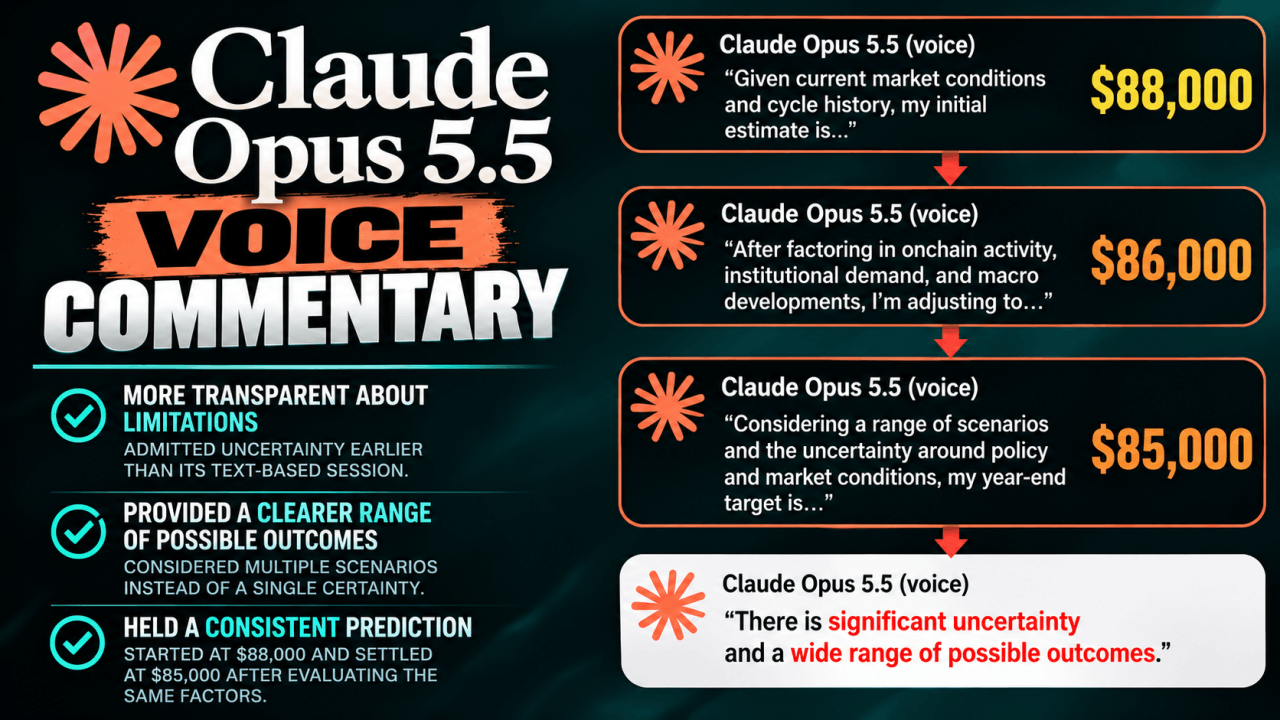
Fue un desempeño más transparente que el de la propia sesión de texto de Claude, que necesitó tres rondas de preguntas para alcanzar un nivel de franqueza comparable. El modelo de voz también describió correctamente que los máximos históricos de los ciclos de Bitcoin suelen producirse entre 12 y 18 meses después de los halvings, y evitó un error de calendario que cometieron tanto la sesión de voz de Grok como la respuesta de texto inicial de Claude.
Aun así, el desempeño de voz de Claude distó mucho de ser impecable. Citó un precio del petróleo superior a 110 $ basándose en una cifra que la revisión consideró desactualizada, exageró la continuidad de las compras institucionales de bitcoin y omitió la caída más profunda del mercado en junio de 2026 al hablar de la caída actual. Tampoco mostró nunca un cálculo que arrojara su objetivo de 85.000 $.
La sorpresa, entonces, no fue que el modelo de voz de Claude se convirtiera en un mejor pronosticador financiero. Fue que, en esta sesión en particular, el asistente de voz fuera más franco sobre sus limitaciones que su equivalente de texto.
Por qué la IA de voz y la de texto no son necesariamente el mismo sistema
La comparación plantea una cuestión técnica que quizá nunca se les ocurra a los usuarios ocasionales: hablar con una IA no siempre equivale a escribirle. La experiencia de voz de ChatGPT de OpenAI utiliza una familia de modelos distinta de la de su experiencia de texto principal. Anthropic, por su parte, describe la función de voz de Claude como operativa mediante la versión más rápida del modelo seleccionado, incluidas las opciones Sonnet y Opus compatibles.
Esa diferencia complica las comparaciones directas. Aunque la interfaz muestre el mismo nombre de modelo, la experiencia de voz puede implicar distintas configuraciones de ejecución, limitaciones de latencia y componentes de procesamiento del habla. El experimento no determinó de forma independiente cómo afectaron esos factores a las respuestas.
El informe no verificó la arquitectura de voz de Grok, por lo que otra parte importante de la comparación técnica quedó sin resolver. Por lo tanto, las sesiones no permiten establecer que la IA de voz sea intrínsecamente menos precisa, más propensa a inventar información o más transparente que la IA generativa de texto. Lo que muestran es que la interfaz y la configuración subyacente importan, y que un nombre de marca conocido por sí solo no garantiza un comportamiento equivalente.
Claude ofreció la comparación más útil dentro de una misma empresa, pero incluso en ese caso las sesiones de texto y voz se realizaron por separado y no constituyeron ensayos repetidos y controlados.
La verdadera prueba llega cuando la IA deja de hablar
En las cuatro sesiones, los pronósticos finales oscilaron entre 78.000 $ y 85.000 $, todos relativamente cerca del precio de mercado vigente de bitcoin. Ninguno mostró cómo sus supuestos se traducían en la cifra exacta que eligió. La revisión también señaló limitaciones en su propia metodología. Claude redactó la evaluación de su desempeño, y varias afirmaciones sobre el mercado se comprobaron mediante fragmentos de resultados de búsqueda, no con fuentes primarias completas.
Ningún registro independiente de herramientas estableció con precisión qué recuperó cada asistente de voz. Esas salvedades son esenciales, pero solo xAI, OpenAI y Anthropic tienen acceso a ellas. Este fue un experimento exploratorio, no una prueba de que una empresa o modalidad de interacción supere sistemáticamente a otra. Sin embargo, dejó al descubierto una diferencia importante entre sonar analítico y mostrar un análisis real.
Los asistentes de voz pueden ofrecer comentarios financieros con el ritmo y la seguridad de un locutor profesional. Los modelos de texto pueden elaborar explicaciones detalladas respaldadas por fuentes recuperadas. Aun así, cualquiera de los dos puede llegar a una conclusión sin respaldo, alucinar o mentir descaradamente, y ambos pueden mejorar cuando se les exige distinguir entre pruebas e inferencias.
La sesión de voz posterior de Claude demostró que hablar con una IA no significa automáticamente sacrificar la transparencia. Al mismo tiempo, ChatGPT y Grok mostraron por qué las respuestas orales bien presentadas merecen el mismo escrutinio que las escritas. Quien use IA para evaluar inversiones debería exigir como siguiente prueba indicaciones idénticas, actividad de recuperación documentada, sesiones repetidas y cifras verificadas de forma independiente.
Solo entonces podrán los investigadores empezar a separar los efectos de la interacción por voz de las capacidades de razonamiento del modelo subyacente. El resultado más revelador del experimento no fue si bitcoin terminaría 2026 en 78.000 $, 82.000 $ o 85.000 $. Fue que cuatro actuaciones convincentes en modo de voz produjeron cuatro conjuntos de razonamientos financieros, y ninguna pudo mostrar las cuentas detrás de su respuesta final.