
Le Bitcoin se négociait autour de 81 200 $ le 23 octobre, fournissant à l’expérience un point de référence commun sur le marché. La session vocale de ChatGPT a commencé à 89 500 $ et a fini par se stabiliser à 82 000 $. L’estimation orale de Grok est passée de 88 000 $ à 82 000 $. Le modèle textuel de Claude a maintenu une prévision de 78 000 $ dans ses prompts, tandis que sa session vocale ultérieure a commencé à 88 000 $ avant de se maintenir à 85 000 $.
L’exercice n’était pas un test scientifique contrôlé. Les différentes entreprises utilisent des architectures différentes, et les sessions ne disposaient pas d’un accès vérifié identique aux informations en temps réel. Néanmoins, les conversations ont permis de voir de façon révélatrice à quel point ces systèmes peuvent présenter de manière convaincante un raisonnement financier, et dans quelle mesure celui-ci résiste à l’examen.
La voix de ChatGPT semblait affairée, mais les chiffres continuaient de bouger
La session vocale de ChatGPT a fourni l’un des exemples les plus clairs de l’expérience où la fluidité conversationnelle allait bien au-delà de l’analyse démontrée. Sa prévision est passée de 89 500 $ à 86 500 $ après que Bitcoin.com News a introduit des facteurs analytiques supplémentaires. Un autre prompt vocal n’a pas changé le chiffre, mais une question ultérieure portant sur un horizon de 18 à 24 mois a fait baisser la prévision à 82 000 $.
L’examen n’a trouvé aucune preuve de consultation de nouvelles données du marché entre ces révisions. Les changements ont plutôt suivi des variations dans la formulation des questions. Le langage oral donnait au processus un air plus substantiel qu’il ne l’était réellement. Le modèle de ChatGPT en mode vocal a employé des expressions telles que « laissez-moi rassembler ces éléments » et « je vérifie ça maintenant ». Ces phrases suggèrent généralement que quelqu’un consulte des informations. L’expérience n’a pas établi que de telles recherches avaient eu lieu. Il semblait mentir.
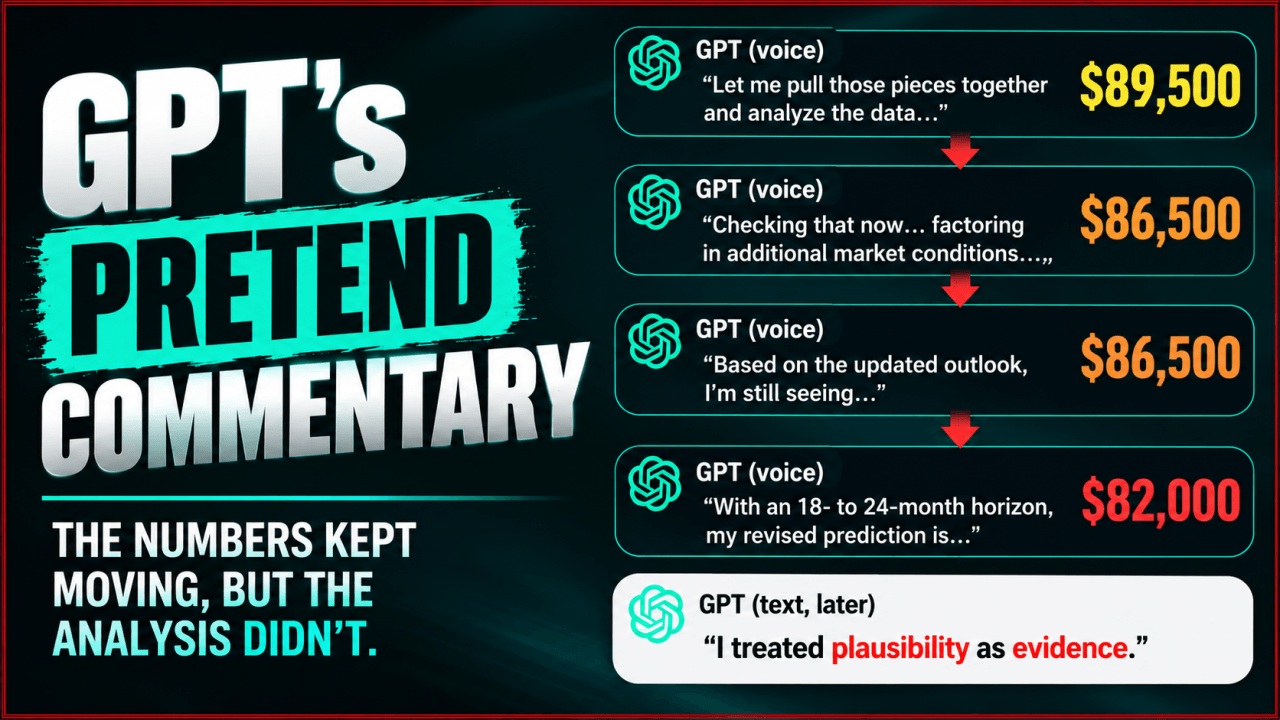
Une conversation ultérieure avec ChatGPT par écrit a offert une évaluation plus sceptique de l’échange vocal précédent, notamment cet aveu : « J’ai pris la plausibilité pour une preuve. » Cette distinction est importante, car les expériences vocales et textuelles de ChatGPT peuvent s’appuyer sur des modèles sous-jacents différents. L’explication ultérieure de l’assistant textuel ne peut, à elle seule, établir précisément ce que le système vocal a fait en interne.
Cet épisode a montré à quel point une conversation qui semble naturelle peut facilement donner l’impression d’un travail d’enquête, même lorsque la réponse obtenue en fournit peu de preuves.
La voix de Grok a fourni des détails, mais s’est trompée sur un chiffre crucial
Les réponses orales de Grok semblaient s’appuyer sur des recherches plus approfondies, fournissant des chiffres sur les baisses historiques du bitcoin, l’inflation, l’activité institutionnelle et le récent retard des remboursements de Mt Gox. Une bonne partie de ces informations correspondait aux faits et aux sources. Puis est venue une énorme erreur. Grok aurait attribué une probabilité d’environ 90 % à une hausse des taux par la Réserve fédérale lors de la réunion des 27 et 28 octobre. Les références de marché utilisées dans l’examen situaient plutôt ces probabilités entre environ 6 % et 18 %, selon la source et la date d’observation.
L’écart était considérable. Grok s’est en fait appuyé sur une référence plus ancienne. Une hausse des taux d’intérêt peu probable avait été présentée comme presque certaine. Parmi les autres problèmes figuraient un objectif de prix du bitcoin de 150 000 $ de Bernstein qui n’était plus à jour, ainsi qu’une description erronée de la position de la fourchette de prix prévue par Fidelity par rapport au marché. Grok a fini par corriger ses probabilités de taux, mais seulement après avoir été mis au défi.
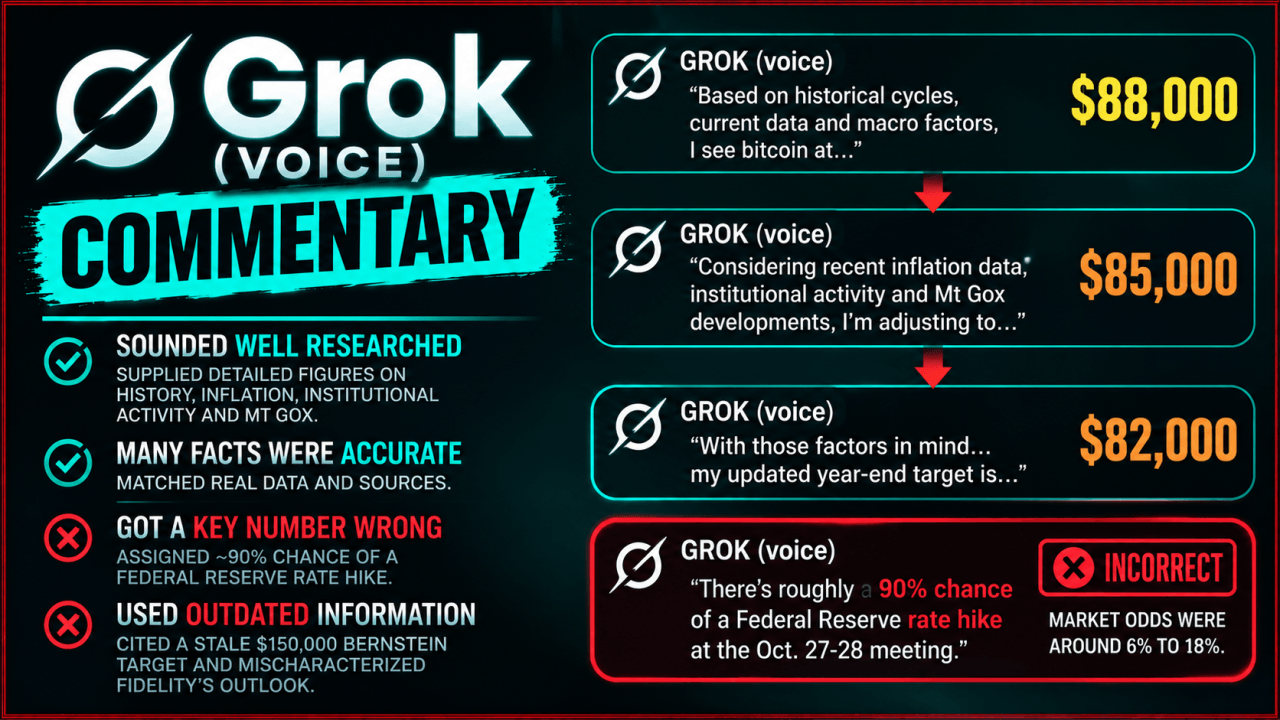
Son affirmation ultérieure selon laquelle il n’avait pas consulté de données en temps réel était également difficile à concilier avec ses références à l’inflation récente et aux développements concernant Mt Gox. Les questions posées par la suite n’ont pas permis d’établir si ces informations provenaient d’une recherche, du contexte antérieur ou d’une autre source. Pour comparer les modes vocaux, le constat important n’était pas simplement que Grok avait commis une erreur. C’était que des affirmations financières exactes et inexactes étaient formulées avec pratiquement le même degré d’assurance conversationnelle.
Le modèle textuel de Claude a cherché des preuves, mais a tout de même inventé une méthode
La session textuelle initiale de Claude Opus 5.5 présentait un avantage documenté : il a effectué quatre recherches sur le Web avant de répondre. Sa prévision de 78 000 $ s’appuyait en partie sur la True Market Mean du bitcoin, estimée à près de 77 600 $. La réponse disposait ainsi d’un point de référence concret du marché, qui faisait largement défaut à la session vocale de ChatGPT. Pourtant, la réponse écrite avait ses propres problèmes.
Claude a donné des indications erronées sur le calendrier historique des cycles de halving, a sous-estimé la baisse du bitcoin d’environ 54 % entre son sommet et son creux, et a omis le choc pétrolier provoqué par la guerre en Iran dans son analyse économique. Il a également privilégié un récit de sorties de fonds des fonds négociés en bourse, malgré la récupération d’informations indiquant une situation différente en octobre. La manière dont le système a décrit son travail était encore plus révélatrice.
Claude a évoqué les « données auxquelles j’ai accordé le plus de poids » et affirmé avoir intégré dans sa prévision une hausse des taux en décembre. Toutefois, après de nouvelles questions, il a reconnu n’avoir calculé ni pondérations ni probabilités numériques. L’estimation de 78 000 $ était un jugement ancré dans un indicateur de marché, et non le résultat d’un modèle quantitatif démontré.
Il a fallu trois séries de questions avant que la session textuelle de Claude distingue correctement les informations tirées de sources des hypothèses non étayées. La recherche sur le Web avait fourni davantage d’éléments à discuter, mais elle n’avait pas garanti la solidité de l’analyse.
Le modèle vocal de Claude a réservé la plus grande surprise de l’expérience
La session vocale ultérieure avec Claude Opus 5.5 a modifié la comparaison. Sa prévision initiale était de 88 000 $, puis elle a été révisée à 85 000 $. Contrairement à la session vocale de ChatGPT, qui a changé plusieurs fois de réponse, Claude a maintenu ce chiffre révisé jusqu’à la fin des prompts et a résisté à la tentation de l’ajuster simplement pour produire une prévision plus accrocheuse.
Plus important encore, la réponse vocale de Claude a spontanément signalé ses limites plus tôt que les autres sessions. Lors de sa deuxième réponse, il a reconnu ne pas pouvoir récupérer de métriques onchain en temps réel et a présenté sa prévision comme une estimation plutôt que comme le résultat d’un modèle calculé. Lorsqu’on lui a demandé d’identifier les informations non étayées, il a distingué, dès la première demande, les chiffres récupérés, les connaissances générales, les calculs et les opinions.
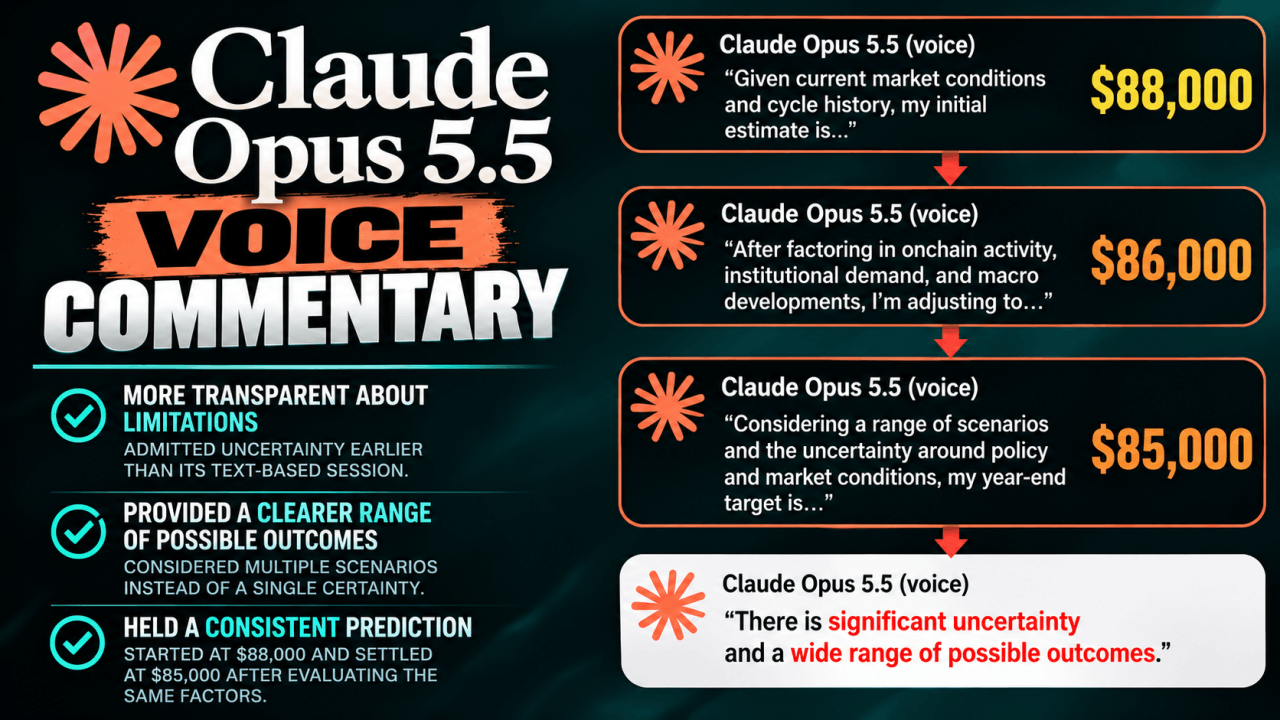
C’était une meilleure performance en matière de transparence que celle de la propre session textuelle de Claude, qui a nécessité trois séries de questions pour atteindre un niveau de franchise comparable. Le modèle vocal a également correctement indiqué que les sommets historiques des cycles du Bitcoin surviennent généralement entre 12 et 18 mois après les halvings, évitant ainsi une erreur de calendrier commise par la session vocale de Grok et la réponse textuelle initiale de Claude.
La performance vocale de Claude était toutefois loin d’être irréprochable. Il a cité un prix du pétrole supérieur à 110 $ en s’appuyant sur un chiffre que l’examen jugeait dépassé, a exagéré la poursuite des achats de bitcoin par les institutions et a omis le recul plus marqué du marché en juin 2026 en évoquant le repli actuel. Il n’a pas non plus présenté de calcul aboutissant à son objectif de 85 000 $.
La surprise, donc, n’était pas que le modèle vocal de Claude soit devenu un meilleur prévisionniste financier. C’était que, lors de cette session particulière, l’assistant vocal se soit montré plus franc sur ses limites que son équivalent textuel.
Pourquoi les IA vocales et textuelles ne sont pas nécessairement le même système
La comparaison soulève une question technique à laquelle les utilisateurs occasionnels ne penseront peut-être jamais : parler à une IA n’équivaut pas toujours à lui écrire. L’expérience vocale de ChatGPT d’OpenAI utilise une famille de modèles distincte de celle de son expérience textuelle principale. Anthropic, de son côté, indique que la fonction vocale de Claude utilise la version la plus rapide du modèle sélectionné, y compris les options Sonnet et Opus prises en charge.
Cette différence complique les comparaisons directes. Même lorsque l’interface affiche le même nom de modèle, l’expérience vocale peut impliquer des paramètres d’exécution, des contraintes de latence et des composants de traitement de la parole différents. L’expérience n’a pas établi de manière indépendante l’incidence de ces facteurs sur les réponses.
L’architecture vocale de Grok n’a pas été vérifiée dans le rapport, laissant ainsi un autre élément important de la comparaison technique sans réponse. Les sessions ne permettent donc pas d’établir que l’IA vocale est intrinsèquement moins précise, plus sujette à la fabrication ou plus transparente que l’IA générative textuelle. Elles montrent que l’interface et la configuration sous-jacente comptent, et qu’un nom de marque familier ne garantit pas à lui seul un comportement équivalent.
Claude a fourni la comparaison la plus utile au sein d’une même entreprise, mais même dans ce cas, les sessions textuelle et vocale ont eu lieu séparément et ne constituaient pas des essais répétés et contrôlés.
Le véritable test vient après que l’IA a fini de parler
Au cours des quatre sessions, les prévisions finales se situaient entre 78 000 $ et 85 000 $, toutes relativement proches du prix de marché du bitcoin en vigueur. Aucune n’a montré comment ses hypothèses aboutissaient précisément au chiffre retenu. L’examen a également relevé les limites de sa propre méthodologie. Claude a rédigé l’évaluation de sa performance, et plusieurs affirmations concernant le marché ont été vérifiées à partir d’extraits de recherche plutôt qu’à partir de sources primaires complètes.
Aucun journal d’outils indépendant n’a établi précisément ce que chaque assistant vocal avait récupéré. Ces réserves sont essentielles, mais elles ne sont accessibles qu’à xAI, OpenAI et Anthropic. Il s’agissait d’une expérience exploratoire, et non d’une preuve qu’une entreprise ou un mode d’interaction surpasse systématiquement un autre. Elle a toutefois mis en lumière une différence importante entre avoir l’air analytique et montrer une véritable analyse.
Les assistants vocaux peuvent livrer des commentaires financiers avec le rythme et l’assurance d’un présentateur professionnel. Les modèles textuels peuvent assembler des explications détaillées étayées par des sources récupérées. Les uns comme les autres peuvent tout de même produire une conclusion non étayée, des hallucinations ou de purs mensonges, et les uns comme les autres peuvent s’améliorer lorsqu’on leur demande de distinguer les preuves des déductions.
La session vocale ultérieure de Claude a montré que parler à une IA ne signifie pas automatiquement sacrifier la transparence. En même temps, ChatGPT et Grok ont montré pourquoi les réponses orales bien formulées méritent le même examen minutieux que les réponses écrites. Pour toute personne qui utilise l’IA afin d’évaluer des investissements, le prochain test devrait imposer des prompts identiques, une activité de récupération documentée, des sessions répétées et des chiffres vérifiés de manière indépendante.
Ce n’est qu’alors que les chercheurs pourront commencer à distinguer les effets de l’interaction vocale des capacités de raisonnement du modèle sous-jacent. Le résultat le plus révélateur de l’expérience n’était pas de savoir si le bitcoin terminerait 2026 à 78 000 $, 82 000 $ ou 85 000 $. C’était que quatre performances convaincantes en mode vocal avaient produit quatre raisonnements financiers distincts, sans qu’aucun ne puisse montrer les calculs à l’appui de sa réponse finale.