
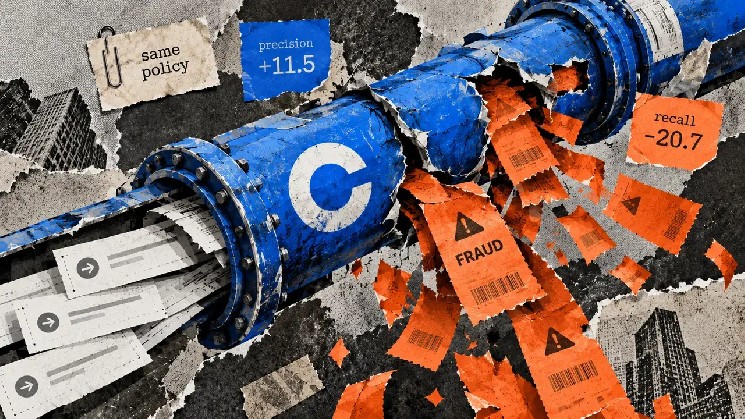
Résultats d’un rejeu historique figé
Coinbase a comparé Opus 4.5 à Opus 5, Sonnet 4.6 à Sonnet 5, et GPT-5.4 à GPT-5.6 (sol). Chaque version plus récente a obtenu un rappel inférieur, un score combiné de précision et de rappel appelé F1 inférieur, et un rappel pondéré par le montant inférieur. Le rappel mesure la part des cas de fraude qu’un modèle détecte ; le rappel pondéré par le montant mesure la part de la valeur totale de la fraude qu’il détecte.
Le rappel de Sonnet a baissé de 22,2 points de pourcentage et son rappel pondéré par le montant a chuté de 22,9 points. Le rappel d’Opus a diminué de 0,8 point. Les deux modèles plus récents ont aussi une précision inférieure, ce qui signifie qu’une moindre part des transactions qu’ils classent comme frauduleuses l’était réellement.
GPT montre pourquoi une amélioration d’un seul score peut être trompeuse. Sa précision a augmenté de 11,5 points de pourcentage, mais son rappel a baissé de 20,7 points et son rappel pondéré par le montant de 21,8 points. Ses signalements de fraude étaient plus précis, tandis que davantage de cas et de valeur frauduleux ont échappé à la détection dans le rejeu.
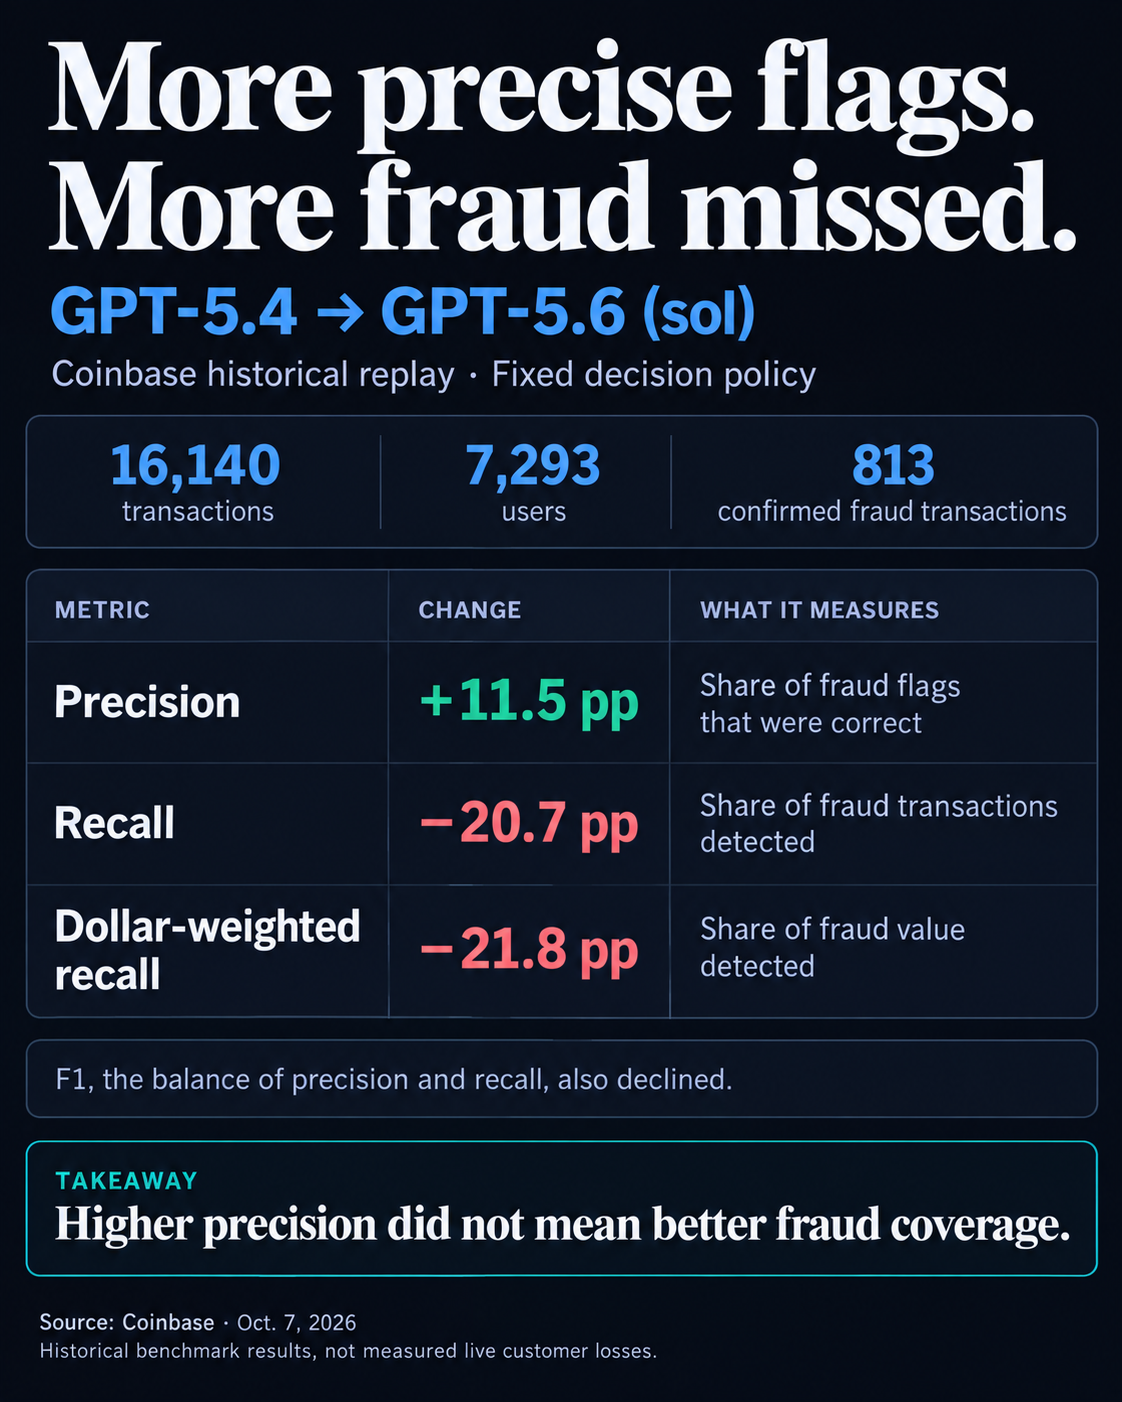
Le rejeu n’établit pas les pertes subies par les clients après le déploiement de ces versions. Coinbase a aussi indiqué qu’elle pouvait identifier les régressions sans établir leur cause.
L’expérience en ligne antérieure de Coinbase comparait l’ajout d’une revue sélective par LLM aux modèles et règles existants seuls. Ce flux assisté par agent a enregistré 30 % de transactions frauduleuses en moins et 22 % de valeur frauduleuse en moins ; il ne comparait pas de nouvelles versions de modèles.
Dans leurs limites, les chercheurs de SR-Fraud indiquent que le jeu de données propriétaire ne peut pas être publié, ce qui restreint la réplication indépendante et la généralisation. Leur étude connexe sur la fraude aux paiements est parue pour la première fois le 23 septembre et a été révisée le 30 septembre, avant les billets de blog d’octobre.
Un argument distinct en faveur d’un modèle sur mesure
Dans sa communication du 8 octobre, Coinbase a indiqué qu’un modèle Qwen3.5-9B post-entraîné dépassait Opus 4.5 sur quatre indicateurs de détection de fraude. Le F1 s’est amélioré de 9,6 points de pourcentage et le rappel pondéré par le montant a augmenté de 35,4 points. L’entreprise l’a spécialisé à partir des résultats historiques de fraude et de récompenses déterministes équilibrant les exemples frauduleux et légitimes.
Par ailleurs, les mesures de production placent la latence médiane de bout en bout des requêtes LLM à 0,683 seconde contre 1,515 seconde pour Opus 4.5, soit une réduction relative de 55 %. Une inférence plus rapide et une détection plus solide dans les benchmarks proviennent d’évaluations différentes.
Pour les prestataires de paiement, la question de la mise à niveau est de savoir si un candidat améliore la couverture de fraude dans leur configuration réelle de décision. Coinbase recommande de tester d’abord cette configuration, puis d’évaluer séparément les invites ou seuils modifiés, en considérant la latence, la fiabilité et le coût en plus de la qualité de détection.