
Ergebnisse aus einer festen historischen Wiedergabe
Coinbase verglich Opus 4.5 mit Opus 5, Sonnet 4.6 mit Sonnet 5 sowie GPT-5.4 mit GPT-5.6 (sol). Jede neuere Version hatte eine niedrigere Trefferquote (Recall), einen niedrigeren kombinierten Wert aus Präzision und Trefferquote, der F1 heißt, sowie eine niedrigere dollargewichtete Trefferquote. Die Trefferquote misst den Anteil der Betrugsfälle, die ein Modell erkennt; die dollargewichtete Trefferquote misst, welcher Anteil des gesamten Betrugsvolumens es erkennt.
Die Trefferquote von Sonnet sank um 22,2 Prozentpunkte, seine dollargewichtete Trefferquote um 22,9 Punkte. Die Trefferquote von Opus ging um 0,8 Punkte zurück. Beide neueren Modelle hatten außerdem eine niedrigere Präzision, das heißt, ein kleinerer Anteil der Transaktionen, die sie als Betrug einstuften, war tatsächlich betrügerisch.
GPT zeigte, warum ein sich verbessernder Wert irreführend sein kann. Seine Präzision stieg um 11,5 Prozentpunkte, doch die Trefferquote sank um 20,7 Punkte und die dollargewichtete Trefferquote um 21,8 Punkte. Seine Betrugsmarkierungen waren genauer, aber in der Wiedergabe entgingen mehr Betrugsfälle und mehr Betrugsvolumen der Erkennung.
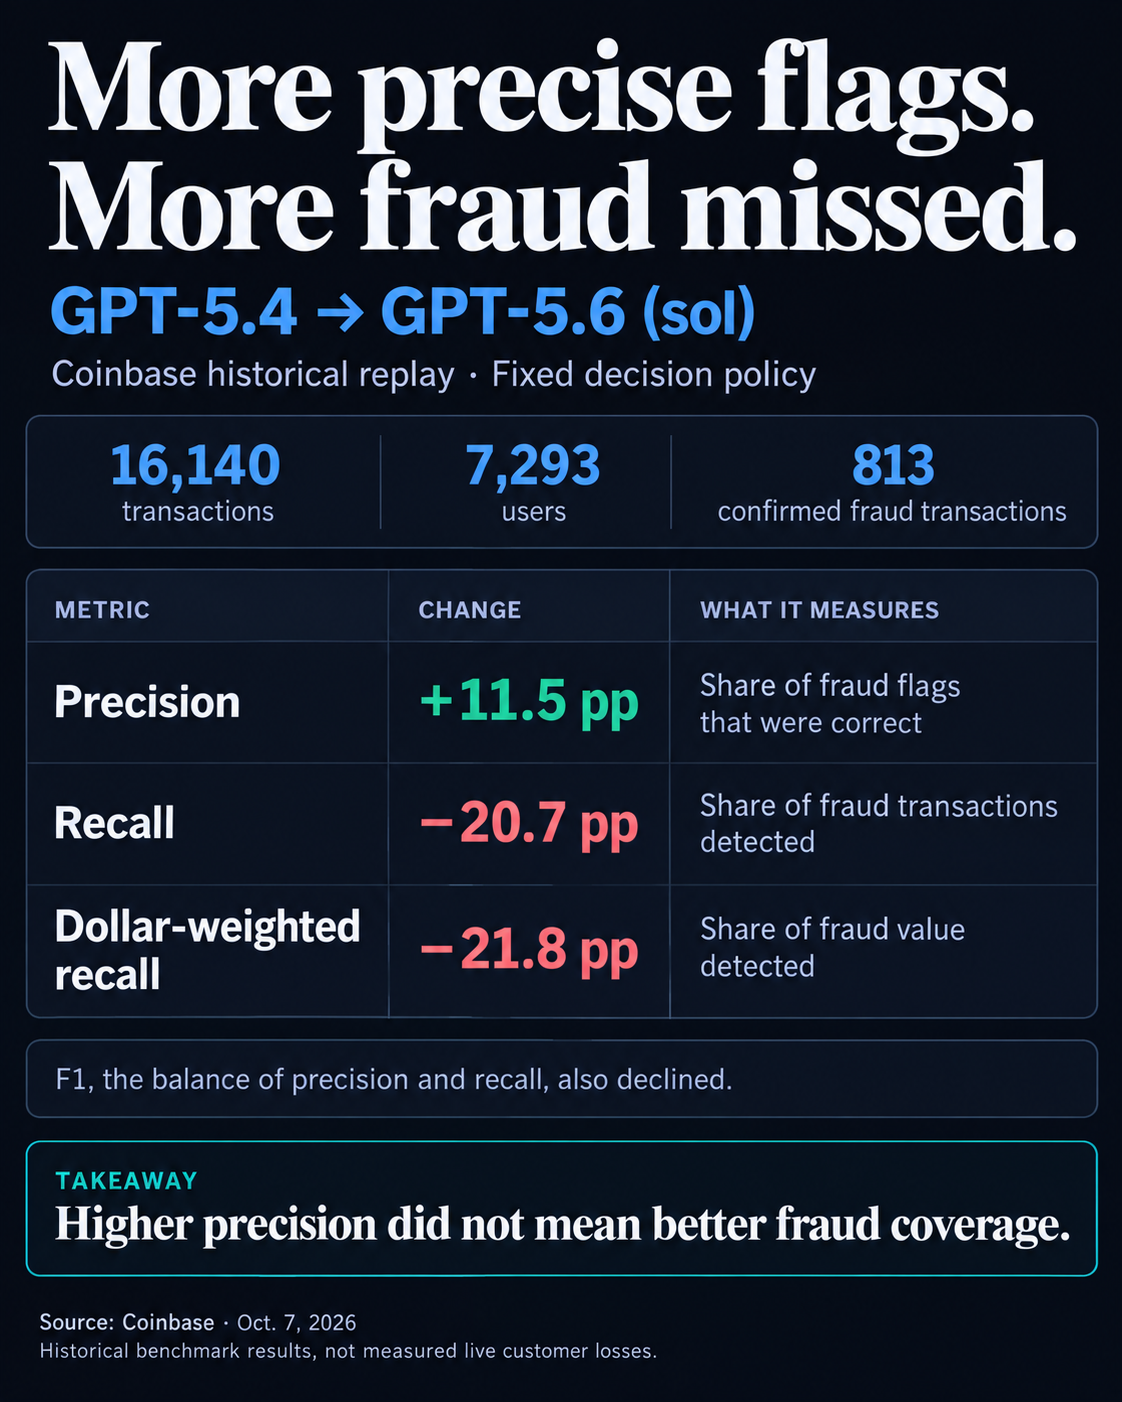
Die Wiedergabe belegt nicht, dass der Einsatz dieser Versionen Kundenverluste verursacht hat. Coinbase erklärte außerdem, es könne die Rückschritte identifizieren, ohne ihre Ursache festzustellen.
Das frühere Online-Experiment von Coinbase verglich eine selektive LLM-Prüfung als Zusatz mit den bestehenden Modellen und Regeln allein. Der agentengestützte Ablauf verzeichnete 30 % weniger betrügerische Transaktionen und 22 % weniger Betrugsvolumen; er verglich keine neueren Modellversionen.
In ihren Einschränkungen erklären die Forscher von SR-Fraud, dass der proprietäre Datensatz nicht veröffentlicht werden kann, was eine unabhängige Replikation und Verallgemeinerung einschränkt. Ihre verwandte Studie zu Zahlungsbetrug erschien erstmals am 23. September und wurde am 30. September überarbeitet, also vor den Oktober-Blogbeiträgen.
Ein gesonderter Fall für ein maßgeschneidertes Modell
In seiner Offenlegung vom 8. Oktober berichtete Coinbase, dass ein nachtrainiertes Qwen3.5-9B-Modell Opus 4.5 bei vier Betrugserkennungskennzahlen übertraf. Der F1-Wert verbesserte sich um 9,6 Prozentpunkte, und die dollargewichtete Trefferquote stieg um 35,4 Punkte. Das Unternehmen spezialisierte das Modell anhand historischer Betrugsergebnisse und deterministischer Belohnungen, die betrügerische und legitime Beispiele ausbalancierten.
Unabhängig davon ergaben Produktionsmessungen eine mediane End-to-End-Latenz bei LLM-Anfragen von 0,683 Sekunden gegenüber 1,515 Sekunden für Opus 4.5, eine relative Reduktion um 55 %. Schnellere Inferenz und stärkere Erkennung im Benchmark stammen aus unterschiedlichen Bewertungen.
Für Zahlungsdienstleister lautet die Upgrade-Frage, ob ein Kandidat die Betrugsabdeckung unter ihrer tatsächlichen Entscheidungskonfiguration verbessert. Coinbase empfiehlt, zuerst genau diese Konfiguration zu testen und danach geänderte Prompts oder Schwellenwerte separat zu bewerten, wobei Latenz, Zuverlässigkeit und Kosten neben der Erkennungsqualität berücksichtigt werden.