
Результаты повторного прогона на фиксированных исторических данных
Coinbase сравнила Opus 4.5 с Opus 5, Sonnet 4.6 с Sonnet 5 и GPT-5.4 с GPT-5.6 (sol). У каждой новой версии полнота (recall) оказалась ниже, ниже была и F1 (сводный показатель, объединяющий точность и полноту), а также взвешенная по сумме полнота. Полнота показывает долю мошеннических случаев, которые модель обнаруживает; взвешенная по сумме полнота показывает, какую часть общей суммы мошеннических операций она выявляет.
Полнота Sonnet снизилась на 22,2 процентного пункта, а взвешенная по сумме полнота упала на 22,9 пункта. Полнота Opus уменьшилась на 0,8 пункта. У обеих новых моделей также снизилась точность, то есть меньшая доля транзакций, которые они классифицировали как мошеннические, действительно оказалась мошеннической.
GPT показал, почему один улучшившийся показатель может вводить в заблуждение. Его точность выросла на 11,5 процентного пункта, но полнота снизилась на 20,7 пункта, а взвешенная по сумме полнота упала на 21,8 пункта. Его пометки о мошенничестве стали точнее, однако в ходе повторного прогона больше мошеннических случаев и больше сумм остались необнаруженными.
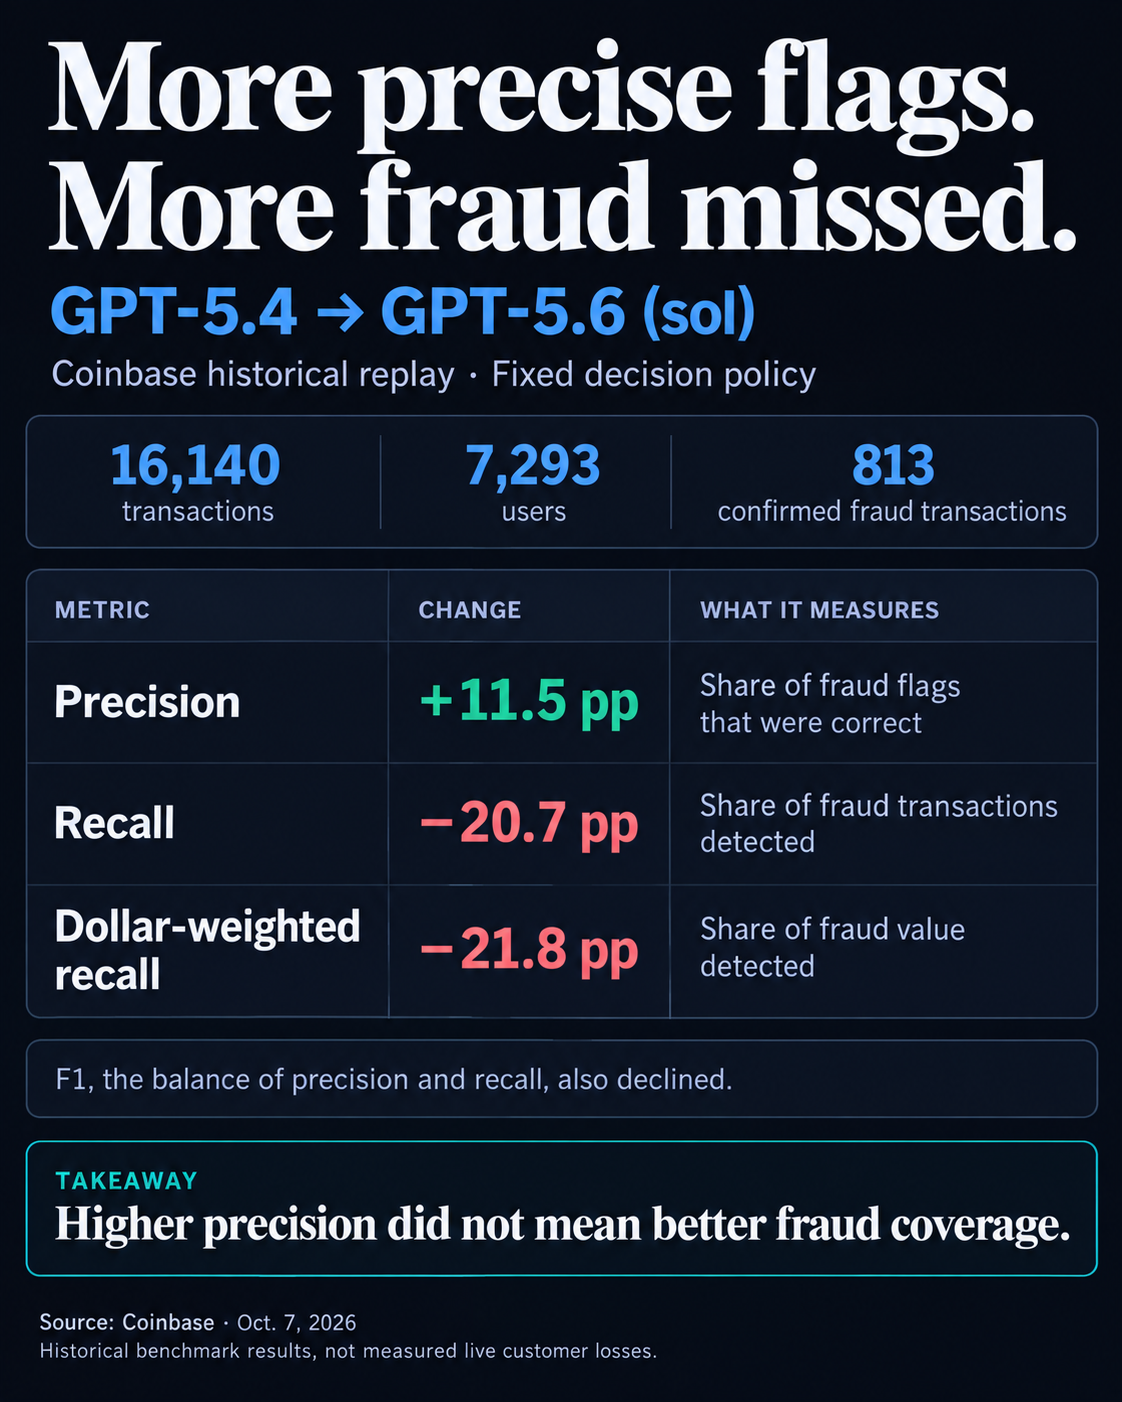
Повторный прогон не устанавливает, что развертывание этих версий привело к потерям клиентов. Coinbase также заявила, что смогла выявить ухудшения, но не установила их причину.
Более ранний онлайн-эксперимент Coinbase сравнивал добавление избирательной проверки с помощью LLM к уже существующим моделям и правилам. Процесс с участием агента зафиксировал на 30% меньше мошеннических транзакций и на 22% меньше суммы мошеннических операций; новые версии моделей в нем не сравнивались.
В разделе об ограничениях исследователи SR-Fraud указывают, что закрытый набор данных нельзя опубликовать, что ограничивает независимое воспроизведение и обобщение результатов. Их связанное исследование мошенничества с платежами впервые появилось 23 сентября и было пересмотрено 30 сентября, то есть до октябрьских блогов.
Отдельный аргумент в пользу собственной модели
В своем раскрытии информации от 8 октября Coinbase сообщила, что дообученная модель Qwen3.5-9B превзошла Opus 4.5 по четырем метрикам обнаружения мошенничества. F1 улучшилась на 9,6 процентного пункта, а взвешенная по сумме полнота выросла на 35,4 пункта. Компания специализировала модель, используя исторические данные о результатах мошенничества и детерминированные награды, которые балансируют мошеннические и легитимные примеры.
Отдельно производственные измерения показали, что медианная сквозная задержка запроса к LLM составила 0,683 секунды против 1,515 секунды для Opus 4.5, что соответствует относительному снижению на 55%. Более быстрый инференс и более сильное обнаружение в тестах получены в разных оценках.
Для платежных провайдеров вопрос обновления заключается в том, улучшает ли кандидатная модель охват мошенничества в их реальной конфигурации принятия решений. Coinbase рекомендует сначала тестировать именно эту конфигурацию, а затем отдельно оценивать измененные промпты или пороговые значения, учитывая задержку, надежность и стоимость наравне с качеством обнаружения.